
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Spring batch PagingReader 로 Update & Delete 시 데이터 처리 누락되는 경우

Spring batch 의 ChunkOrientTasklet 에서 Reader 를 PagingItemReader, Writer 에선 삭제 Operation 을 할 때, 누락이 발생할 수 있음을 알리는 글 입니다.
Chunk 단위 Transaction 처리
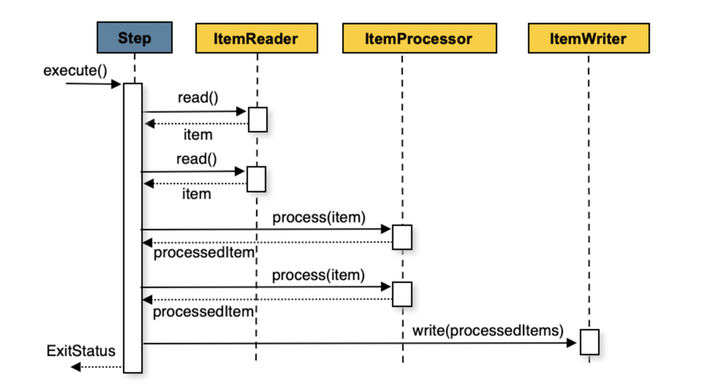
spring batch 는 chunk 단위로 처리를 합니다.
처리할 전체를 읽어서 한번에 넘기는 방식이 아닌! 일부를 읽고 그 일부를 처리한 뒤 commit 하는 사이클을 반복하는데요.
그 chunk 의 사이즈는
step을 구현할 때.chunk(int size)를 통해서 설정합니다.
@Bean
public Step step1() {
    return this.stepBuilderFactory.get("step1")
        .<String, String>chunk(chunkSize) // 요기서
        .reader(fooReader())
        .processor(fooProcessor())
        .writer(compositeItemWriter())
        .stream(barWriter())
        .build();
}
PagingItemReader 에 관하여
pagingReader 의 경우 한번 읽을 때 가져오는 데이터 양인 fetch size 를 셋팅하는 옵션이 무조건 있습니다. (chunk 개념과 다릅니다.)
chunk-size와reader fetch size가10으로 같다고 가정할 해봅시다.그러면
한번 10개 Read -> 한번 10개 Write를 한 트랜잭션으로 반복하게 됩니다.1번부터 10번까지한번 가져오고,10개를 건너뛰고 11번부터 20번까지 한번 가져오는 식으로 동작을 하는데요.10개를 건너뛰고 이것 때문에 이 글을 쓰게 되었네요.
실제 설정은 아래와 같이합니다.
@Bean
public JdbcPagingItemReader itemReader(DataSource dataSource, PagingQueryProvider queryProvider) {
    Map<String, Object> parameterValues = new HashMap<>();
    parameterValues.put("status", "NEW");
	  return new JdbcPagingItemReaderBuilder<CustomerCredit>()
              .name("creditReader")
              .dataSource(dataSource)
              .queryProvider(queryProvider)
              .parameterValues(parameterValues)
              .rowMapper(customerCreditMapper())
              .pageSize(10)  //처음 조회는 1번 ~ 10번, 그 다음은 읽을 떈 "10개 건너뛰고" 11번 ~ 20번
              .build();
}
조건을 건 Update & Delete Write 시 Paging Reader 로 읽을 때 데이터가 누락되는 현상
일반적으로 스프링 배치를 데이터를 읽고 처리해서 다른곳으로 마이그레이션 하는 용도로 많이 사용하는데요.
지울 때는 잘 생각해서 Reader 를 구성해야합니다.문제 발생 flow
처음에 Reader 가 10개를 가져옴 -> writer 로 10개를 넘겨서 삭제
페이지 하나 증가해야하니, 두번째 Reader 가 10개를 건너뛰고 10개를 가져옴 -> writer 로 10개를 넘겨서 삭제
2번의 단계에서 지워야할 10개를 건너뛰었습니다.
그렇게 계속 프로세스가 진행이되면 다 끝나고 난뒤 딱 절반정도만 지우게 됩니다.
결과 : 이빨이 빠지는 느낌으로 chunk 단위 실행이 될 때마다 한 뭉탱이씩 읽는것을 누락합니다.
이는 한번 읽기를 진행되고나면
page++를 하고 쿼리 실행시getPage()를 하는 문제로 인해 발생합니다.
대응방법
1. 지울 데이터보다 chunk size 를 크게 잡는다. ( =한 번의 트랜잭션으로 끝낸다.)
무식하지만 쉽습니다. 네트워크 리소스도 많이 쓸 필요 없이, 일괄로 모아서 한방에 보내버리는 방법이죠.
다만 데이터가 큰 경우 WAS 의 Heap 메모리를 많이 차지하게 되고,
DB 로 한번에 넘길 시 갑작스런 DB 부하도 주어질 수 있습니다.
가장 큰 문제로 하나의 transaction 이므로
write 도중 실패시 전부다 롤백을 하는 비상사태가 일어납니다.DB 부하를 덜주는 방법으로는, 아래처럼 writer 를 직접 구현해서 일정 partition 별로 나눠서 지우게 하는 방법이 있지만, 어플리케이션은 데이터를 전부 메모리에 들고 있어야하는건 사실입니다.
필드 6개 정도 가지고 있는 Java Object 20만개의 메모리 용량이 200MB 정도 됩니다.
for(List<Object> writes : 50개씩 나눠서 2차원 배열로 만든 전체 데이터)
insert(writes)intellij에 자체적으로 들어있는 memory dump 기능을 이용하면 넘어온 객체가 얼마나 메모리를 먹고있나를 볼 수 있습니다.이를 통해 실서버에서 셋팅된 Heap memory size와 데이터가 차지하는 용량을 비교했을 때, 큰 문제 없을 것 같다고한다면 진행해도 되겠죠.
실제로 실행할 때는 pinpoint 같은 APM 툴을 이용해서 JVM Heap 의 상태를 관찰해주는게 필요할 것 입니다.
다만 스마트해 보이진 않습니다.
2. page 사이즈를 항상 0으로 할 수 있게 오버라이딩 한다.
항상 읽을 때 맨 앞 chunk만 바라보게 합니다. 한번 transaction 이후 지우고나서도 맨 앞을 바라보니 누락될일이 없죠.
구현체 마다 다르겠지만, MyBatisPagingItemReader 내부적으로 들고 있는 page 사이즈는 올라가더라도,
실제 쿼리 실행할 때는 늘 맨처음 기준으로만 가져오도록 하여 이 중간 이빨빠짐 현상을 피할 수 있습니다.
일반적으로 가장 쉽게 이렇게 회피를 하는 것 같습니다.
    @Bean
    @StepScope
    public ItemReader<Order> itemReader() {
        MyBatisPagingItemReader<Order> itemReader = new MyBatisPagingItemReader<Order>() {
            @Override
            public int getPage() {
                return 0;
            }
        };
        itemReader.setQueryId("query-name");
        itemReader.setPageSize(PAGE_SIZE);
        itemReader.setSqlSessionFactory(sqlSessionFactory);
        return itemReader;
    }
3. CursorReader 를 통해서 읽는다.
CursorReader 는 Driver 와 DB 가 둘다 지원이 되어야 쓸 수 있습니다.
mysql 인 경우
useCursorFetch=true옵션을 주고 connection 을 형성해야 동작합니다.
대표적으로
JdbcCursorItemReader같은 것이 있는데, 커넥션을 계속 이어둔 상태로 streaming 같이 메모리엔 일정 숫자만큼만 쭉쭉 db 로 부터 빨아들이고 다 처리하면다음 것을 가져오는 식 입니다. 이에 앞에 데이터가 지워지는 것과 상관없이 적은 메모리로 누락없이 처리 할 수 있습니다.
다만 트랜잭션을 길게가져가게되고, wire shark 로 살펴볼 시 네트워크 통신도 많아지며, 커넥션 타임아웃도 길게 가져가야합니다.
4. 그냥 몇 개 누락하더라도 job 을 여러번 돌려서 마무리 한다. ㅎㅎ
데이터 성격상 그냥 한번 지워버리고, 반드시 한번에 안 지워져도 되는 녀석들이 있습니다.
그러면 그냥 큰 고민하지말고, 여러번 job 을 돌려서 첫번째 실행
SELECT * FROM table LIMIT 0, n이 지워줄거라고 믿어도 됩니다..대신 좀 자괴감은 들 수 있습니다.
후기
chunk 기반 동작이라는걸 명심하고 배치를 개발하면 사실 쉽게 파악할 수 있는 이슈입니다.
하지만 바쁘기도하고... 빠르게 개발하다보면 하기도 쉬운 실수로 보이네요..
이 글은 개인 블로그에도 업로드 되어있습니다.
오소리 님의 최신 블로그
더보기-
- Spring batch PagingReader 로 Update & Delete 시 데이터 처리 누락되는 경우
- Spring batch 의 ChunkOrientTasklet 에서 Reader 를 PagingItemReader, Writer 에선 삭제 Operation 을 할 때, 누락이 발생할 수 있음을 알리는 글 입니다. Chunk 단위 Transaction 처리 spring batch 는 chunk 단위로 처리를 합니다. 처리할 전체를 읽어서 한번에 넘기는 방식이 아닌! 일부를 읽고 그 일부를 처리한 뒤 commit 하는 사이클을 반복하는데요. 그 chunk 의 사이즈는 step 을 구현할 때 .chunk(int size) 를 통해서 설정합니다. @Bean public Step step1() { return this.stepBuilderFactory.get("step1"...
-

- Spring Batch 는 어떻게 Chunk 지향처리를 하고, Transaction을 언제 걸까
- Spring Batch Chunk Oriented & Transaction 맨날 StepBuilder.java 나 JobBuilder.java 로 기계적으로 job 을 만들다 보면, 너무나 많이 추상화 된 프레임워크에 의해 바보가 되는 느낌을 자주 받습니다. 작업을 하다 이 프레임워크는 어느 타이밍에 Transaction 을 걸고, 어떻게 Chunk 지향처리를 하는지 궁금해졌습니다. Spring Batch 는 chunk 단위로 데이터 처리를 합니다. Job - Step - Tasklet - Reader + Process + Writer 계층을 이루고 있는 점. 그리고 Tasklet 내 chunk 단위 처리 중 에러가 발생하면 롤백 한다는 내용은 많은이가 알고 있습...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.