
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
좀 더 정확하고 빠른 Dialogue Retrieval 방법
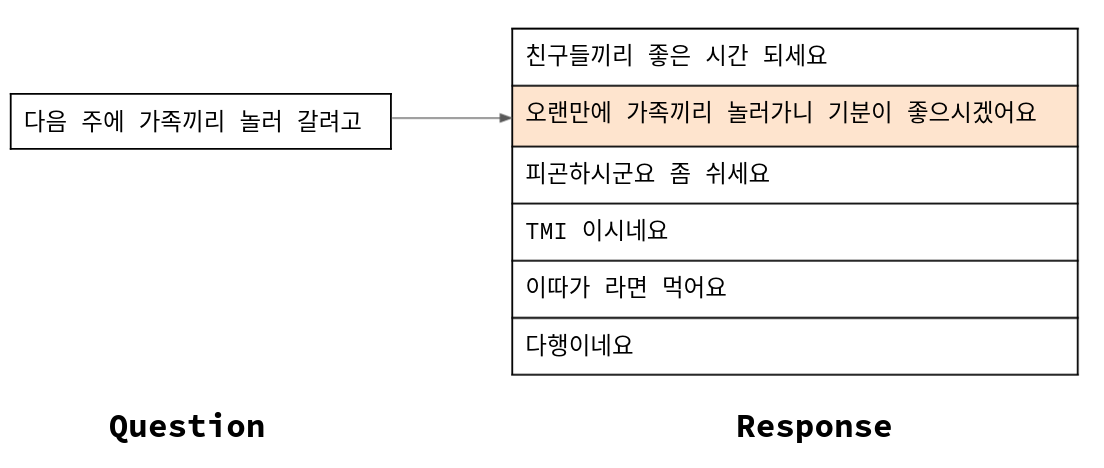
Dialogue task는 입력에 대해 적절한 답변을 선택하는 task로 간단히 생각해 볼 수 있습니다. 이를 모델 입장에서 말하면, 적절한 답변을 출력하기 위해 input 과 response candidate들 간에 적절한 scoring 작업을 수행한다고 얘기할 수 있습니다.
예를들어 아래와 같이 "다음 주에 가족끼리 놀러 갈려고"라는 1개의 input이 있고 {"친구들끼리 좋은 시간 되세요.", "오랜만에 가족끼리 놀러가니 기분이 좋으시겠어요.", "피곤하시군요 좀 쉬세요" ...} 등과 같은 response candidate set이 있다고 한다면 적절한 response를 선택하기 위해 input과 각 candidate에 스코어링을 진행하는 것으로 설명 할 수 있습니다.(multi sentence scoring)
이처럼 검색(Retrieval)은 입력에 대해 관련 높은 여러 후보에서 적합한 답변을 선택하는 Multi sentence scoring을 요구하는 task입니다. 앞서 말씀드린 적절한 답변을 선택하는 문제나 혹은 질의에 대한 문서 검색 영역에도 해당합니다.
검색(retrieval)의 방법, 즉 입력 시퀀스와 이에 대응하는 레이블 시퀀스 간에 비교를 수행하는 방법에는 Bi-Encoder와 Cross-Encoder 방식이 있습니다. 아래 부터는 기존 방식에 대해 속도와 성능 면에서 장단점과 지난 2020년 Facebook AI Research에서 릴리즈한 Blender bot 1.0의 Poly-Encoder 모델에 대해 설명하고, 실용적인 부분에서 Poly-Encoder가 어떤 점을 기여했는지를 설명하고자 합니다.
Bi-Encoder, Cross-Encoder, Poly-Encoder 모두 이제는 일반화된 자연어처리 학습 방식이라고 말할 수 있는 사전학습된 언어모델을 기반으로 각각의 학습방식을 파인튜닝합니다.(이를 Transfer Learning이라고도 합니다.) 여기서는 사전학습 언어모델로 BERT를 사용해 설명하겠습니다.
각각의 입력(INPUT)과 답변(LABEL)은 3개 embedding을 합친것으로 표현됩니다. 토큰 임베딩, 포지션 임베딩 그리고 세그먼트 임베딩 입니다. 입력 토큰에 대한 세그먼트는 0이며 label 토큰에 대한 세그먼트는 1입니다. 이후 INPUT과 LABEL은 구분자인 스페셜 토큰인 [S] (Seperate token)을 주변에 붙여 입력으로 사용하게 됩니다.
Bi-Encoder
Bi-Encoder는 먼저 input과 candidate label에 대해 별도의 벡터로 인코드됩니다. 여기서 input과 label이 별도로 인코드 된것 처럼, 세그먼트 토큰들은 모두 0 입니다. 즉 각각의 input과 candiate를 사전학습 언어모델에 입력으로 전달하여 벡터 표현을 얻도록 합니다. 그 후 이 출력을 matrix를 통해 차원을 축소하는 작업을 거칩니다. 이는 아래와 같이 표현이 가능합니다.
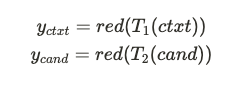
T_1과 T_2는 앞서 설명한 사전학습된 언어모델(BERT) 입니다. 당연히 처음에는 동일하게 초기화 되어있을 수 있지만 파인튜닝을 거치면서 별도로 업데이트가 될 것입니다. 그리고 이 T의 출력은 입력길이가 N이라면 입력 x에 대해 T(x) = h_1, .., h_N를 출력으로 내게 됩니다. 결과적으로 입력 x간에 self-attention을 수행하여 N개의 표현을 내게 됩니다. 이 후 red()로 표현된 weighted-sum을 처리하여 멀티 표현으로되어 있는 벡터를 하나의 벡터로 축소하여 학습하는 내용을 좀 더 선명해지도록 하는 효과를 가져옵니다.
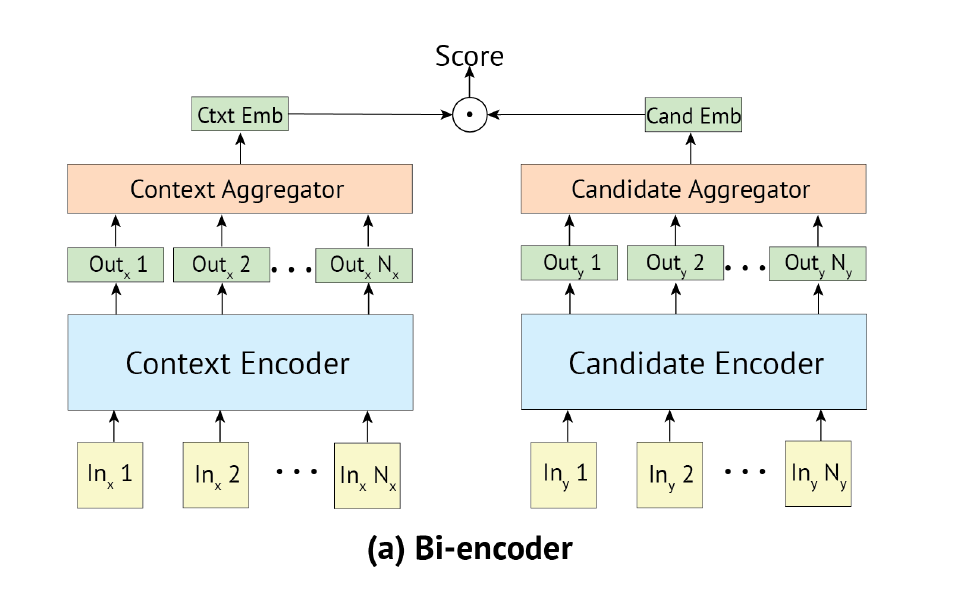
이제 후보 cand_i의 점수는 s(ctxt, cand_i) = y_{ctxt} \cdot y_{cand_i}인 dot-product로 계산됩니다. 모델은 cand_1은 정답 레이블이고 다른 것들은 학습 셋에서 가져온 y_{ctxt} \cdot y_{cand_1} , ..., y_{ctxt} \cdot y_{cand_n}인 s(ctxt, cand_i) logit의 cross-entropy loss를 최소화하도록 학습됩니다. 여기서 cand_1은 올바른 후보(label)이고 나머지는 훈련 세트에서 가져온 negative samples입니다.
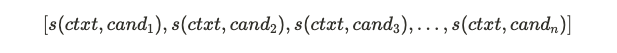
Bi-Encoder의 최대 장점은 input과 label을 별도로 encoding하기 때문에 representation이 분리되어있어 미리 계산한 임베딩을 캐싱할 수 있어 속도에 매우 빠르다는 것입니다. 이는 다시 말해, FAISS나 Annoy와 같은 MIPS tool을 사용해 임베딩을 해싱하여 매우 빠르게 처리할 수 있습니다.
위의 3가지 Cross-Encoder와 Poly-Encoder에 대한 설명은 이후 post에서 이어서 하겠습니다.
References
- [1] Poly-encoders_ Transformer Architectures and Pre-training Strategies for Fast and Accurate Multi-sentence Scoring, Samuel Humeau et al., 2019
- [2] Blender Bot — Part 2: The Transformer
대니얼(김대규) 님의 최신 블로그
더보기

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.