
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
[Python] Numpy가 빠른 이유-2편 (PyObject와 메모리 구조 관점에서)

오늘 포스팅은 Python의 대표 Math Package중 하나인 Numpy에 대해서 다룹니다.
지난번 포스팅에서 하드웨어 관점에서 Numpy의 빠른 연산의 방법에 대해서 살펴봤습니다.
([Python] Numpy가 빠른 이유-1편 (하드웨어 관점에서, SIMD) (sk.com))
하지만, 의문점이 듭니다.
SIMD로 한번에 N배의 데이터를 처리하면, Python의 소요시간 = Numpy의 소요시간 * N이 나와야 합니다. 과연 그럴까요?
import numpy as np
import copy
import random


def np_add(a, b, ret):
    ret = np.add(a, b)
    return ret

def py_add(a, b):
    ret = [i + j for i, j in zip(a, b)]
    return ret


py_a = [float(random.randint(0, 1000)) for i in range(1000000)]
py_b = [float(random.randint(0, 1000)) for i in range(1000000)]
py_ret = [None for i in range(1000000)]
np_a = np.array(copy.deepcopy([np.float(i) for i in py_a]))
np_b = np.array(copy.deepcopy([np.float(i) for i in py_b]))
np_ret = np.array(copy.deepcopy(py_ret)).astype(np.float)

%timeit np_add(np_a, np_b, np_ret)
#==>3.34 ms ± 133 µs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit np_add(py_a, py_b, py_ret)
#==>136 ms ± 2.6 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
테스트 컴퓨터는 AVX2 까지만 지원합니다(256 bit 범용레지스터)
그렇다면, 64bit인 float을 한번에 4개씩 처리가 가능하고(64*4 = 256bit), 4배만큼만 빨라야합니다.
하지만 결과를 보면 136ms/3.4ms = 약 40배가 빠르다는것을 확인할 수 있습니다!
드디어 조상님이 계산을 대신 해주신걸까요?
아래 Numpy Array와 Python Array의 내부 구조를 잠시 비교해 보겠습니다.
Python List의 추상화 이미지

Numpy Array의 추상화 이미지
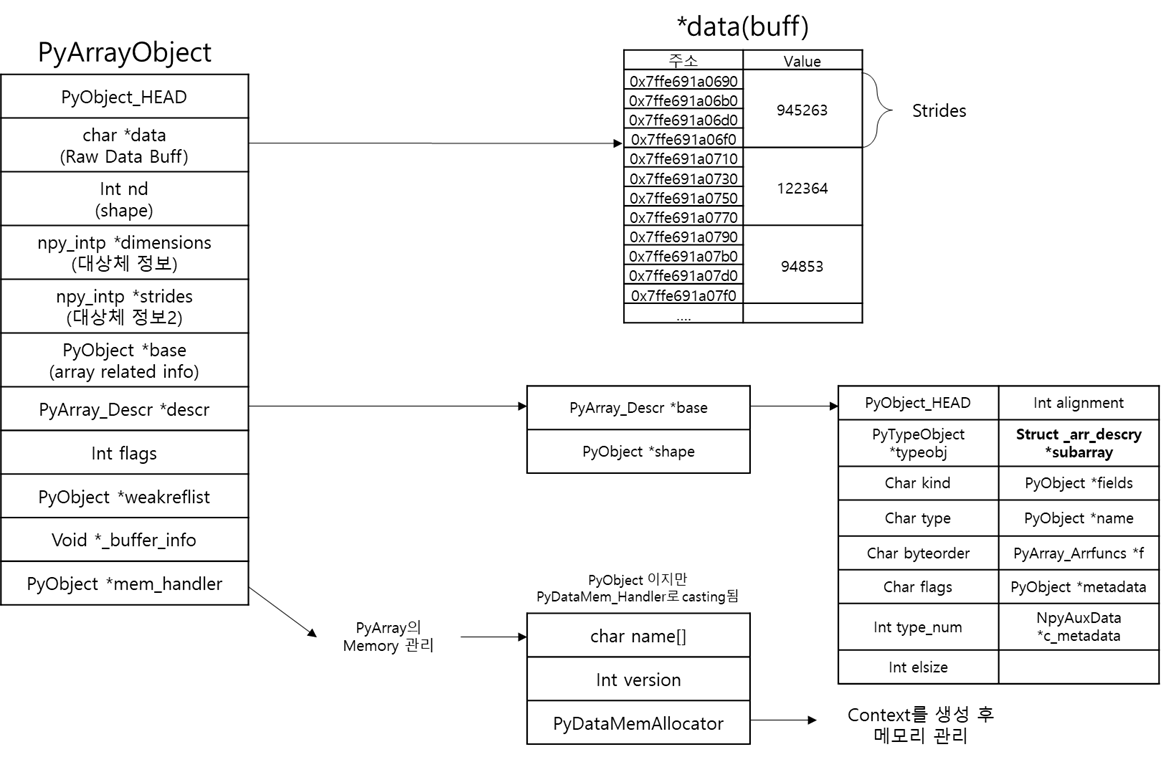
가장 대표적인 차이점으로, Python Array는 Item을 2중 포인터 형식으로 저장하며, 여기에 PyObject가 저장됩니다.
반면, Numpy의 경우 단일 포인터로 Buff의 첫 주소를 가리키고, Buff에서 ctype의 데이터가 C Array에 저장됩니다.
이 구조때문에 두가지 차이점이 발생합니다.
1. PyObject의 연산
PyObject의 Binary 연산은 해당 사이트를 참고하시면 좋을것 같습니다(https://cyril.deguet.com/en/2015/06/15/how-python-code-is-executed/)
Python에서 Int, str, float으로 지정한 변수는 c언어 int, char, double과는 다릅니다.
최종적으로 포인터가 가리키는 값을 c언어의 그것과 비슷하지만, 해당 변수의 연산은 아래와 같이 inception이 들어갑니다.
PyObject Type의 연산과정(ex. add)
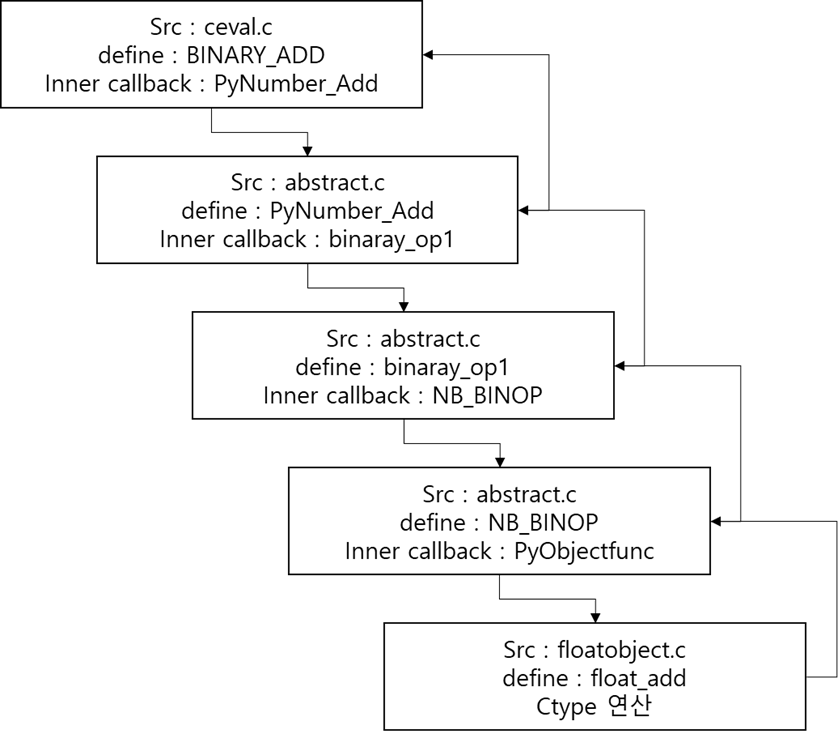
이 과정에서 중간중간 type을 체크하는 다수의 예외처리가 존재하기 때문에, Ctype연산만으로 처리가 가능한 Numpy Array 대비 Python List의 연산은 느릴 수 밖에 없습니다
(c[i] = a[i] + b[i]을 한번 할때마다 위 과정이 필요하니깐요!)
2. 데이터의 지역성
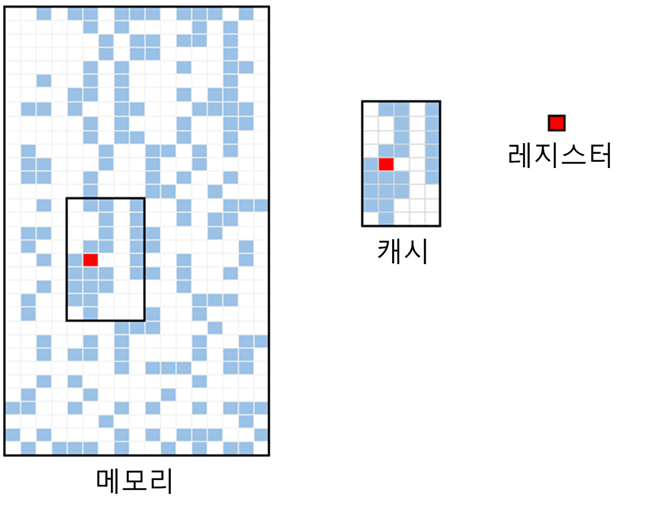
잠시 지루한 이야기를 해 보겠습니다. 컴퓨터구조 수업을 들어보신 분들이라면, 아래와 같은 계층도를 잘 알고있을 겁니다.
컴퓨터 메모리 계층도
출처 : https://computerscience.chemeketa.edu/cs160Reader/ComputerArchitecture/MemoryHeirarchy.html
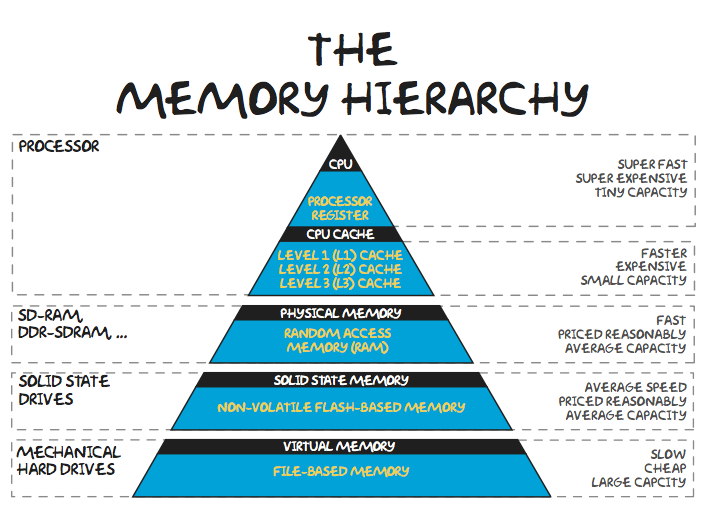
RAM이 아무리 빨라봐야 Cache보다 턱없이 느리고, Cache가 커봐야 램보다는 너무 작습니다.
이 문제를 해소하고자 CPU는 사용할 Data를 Cache에 저장해놓고, 빠르게 register로 가지고와서 계산을 진행합니다.
하지만, CPU가 Data를 찾을 때 Data가 Cache에 없으면 이 데이터를 RAM, 나아가서는 SSD에서 찾아야하고, 이는 엄청난 시간이 소요되게 됩니다.(이것을 Cache miss라고 합니다)
이러한 Cache miss를 방지하기 위해서 RAM과 Cache사이에는 Cache Line단위(일반적으로 64byte)로 필요한 데이터 + 주변의 데이터 통째로 가지고옵니다.
이때 Memory의 주변 Data를 사용할 확률이 높다는 점(Data의 공간지역성 이라고 합니다)을 활용해서 주변 데이터를 가지고 오게 됩니다.
추상화한 data의 지역성을 설명하는 이미지(사용할 데이터 주변 데이터를 통째로 가지고가는 이유)
빨간색 : 당장 필요한 데이터, 하늘색 : 필요할 데이터, 흰색 : 사용하지 않을 데이터
이런 지루한 이야기를 한 이유는, Python List와 Numpy Array의 연산속도의 차이를 만드는 나머지 부분이기 때문입니다.
Python List의 경우 PyListObject->PyObject->ob_item->.... 과 같은 형태로 되어있습니다. 때문에 여러번 memory allocation이 발생합니다.
즉, Python List a[0]과 a[1]의 PyObject를 가리키는 포인터주소는 메모리 상에서 인접하지만, 실제 데이터는 메모리 상에서 인접한다는 보장이 없습니다.
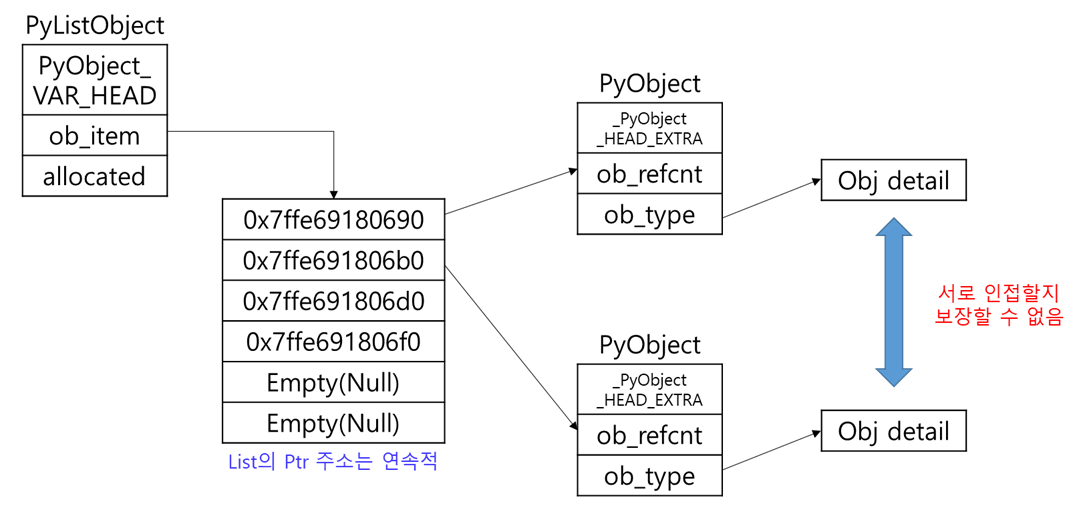
Python List의 위와같은 구조 때문에 Python List는 자체적으로 SIMD를 지원하지 않는 것으로 알려져있습니다.
(SIMD 연산을 위해서는 Data가 정렬되어 있어야 합니다)
반면, Numpy의 경우 미리 할당된 buff에 데이터가 C Array형태로 저장됩니다. 때문에 C malloc수준의 데이터 연속성을 보장받을 수 있습니다.
즉, Numpy Array는 Python List보다 cache hit rate가 높고, 이러한 다수의 요인이 겹쳐서 Numpy Array가 Python List보다 빠르다고 할 수 있겠습니다.
이상 Numpy가 빠른 이유 2편 이었습니다.
Teus 님의 최신 블로그
더보기-
- LLM의 thinking_token_budget은 어떤 역할을 하는가?
- 안녕하세요. teus입니다. 이번 포스팅은, opencode 등의 LLM에서 설정할 수 있는 thinking_token_budget에 대해서 다룹니다. 0. Effort opencode나 claude code의 설정에 보면, 모델의 reasoningEffort를 수정 할 수 있습니다. https://opencode.ai/docs/models/#configure-models 문제는 위와같이 reasoningEffort라고 지정되어있는 변수의 경우 직접적으로 어느정도의 reasoning을 진행할 지를 우리가 알 수는 없고 enable_thinking 활성화 여부와 system prompt의 일부분에 영향을 끼친다고 이야기 했습니다. claude code의 reason...
-
- claude code의 reasoning effort는 vllm에도 효과가 있는가?
- 안녕하세요. teus입니다. 이번 포스팅은, claude code에서 설정할 수 있는 reasoning effort가 과연 효과가 있는지 소스코드 레벨에서 점검해봅니다. 0. Effort claude code를 보면, 위처럼 effort를 설정할 수 있습니다. 원래 claude 모델을 쓸 때는 위와같은 설정을 쓰는게 가정하고 학습이 되었겠지만 사내에서는 claude 모델이 아니라, vLLM기반의 OSS모델을 사용 중 입니다. 그러면 과연 해당 기능이 제대로 동작할 수 있을까요? GLM 5.2 모델 기준 flow(정리본) Claude Code /effort high │ ▼ POST /v1/messages output_config.effort = "high" │ ▼ ...
-

- AI Agent 속도 최적화를 위한 Speculative Decoding
- 안녕하세요. Teus입니다. 이번 포스팅은 Speculative Decoding이라는 방법을 통해서 어떻게하면 AI Agent의 Latency를 개선할 수 있을지 생각해 봅니다. 1. Speculative Decoding? Speculative는 구글에서 검색해보면 Speculative : 투기적인 이라는 단어로 검색됩니다. Speculative Decoding은 CPU의 분기예측과 비슷한데 앞으로 해야 할 행동을 몇가지 찾아놓고 그 행동이 맞으면 현실로 옮기고, 아닐경우 폐기하는 컨셉을 통해서 AI Agent의 Token 속도를 올리는 방법입니다. 2. 어떻게? 원리를 비유적으로 표현하면 학생이 빠르게 대충 문제를 풀게하고 선생님 다수가 그 결과를 체점해서 틀린...
-

- A2A 튜토리얼 코드 톺아보기
- 안녕하세요. Teus입니다. 이번 포스팅은 A2A(Agent 2 Agent) Protocol이 뭔지 간단히 알아보고 부실한 tutorial을 채우기 위한 공식 튜토리얼 코드를 간단히 톺아보겠습니다. 0. A2A A2A(Agent To Agent)는 Google에서 25년 4월 9일 구글에서 발표한 프로토콜 입니다. 이름에서 볼 수 있듯, AI Agent 〈-〉 AI Agent간 통신을 위한 프로토콜 입니다. MCP를 사용 할때까지는 MCP를 통해서 MCP Server에 저장된 Tools, Resource, Prompt를 불러오고 이 Tools를 활용해서 Agent를 각자 구축 하는 방식 이었습니다. 이제 A2A를 이용해서 Agent를 각자 구현하지 말고 각자 만든...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.