
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Kubeflow 란 무엇인가? (a.k.a AI Platform)

2018년에 Kubernetes 상에서 돌아가는 ML Platform 인 Kubeflow 를 처음 알게된 후로 관심을 갖고 재미삼아 하다가 2022년에는 업무와 연관되어 일을 해야하기 때문에 중점으로 살펴보고자 한다. (최근에는 ML Platform 보다는 AI Platform 이라고 말하는 사람들이 많은 듯)
Kubeflow 를 KubeCon 에서 만나다
Kubeflow 개발자들을 처음 만난 것은 2019년 KubeCon in Europe (Barcelona) 이다. 초기 Kubeflow 는 Goolge 과 Arrito 가 주축이 되어 개발하고 있었는데 마침 초기 버전이 나오면서 Kubeflow 홍보를 시작하던 때 였었다.
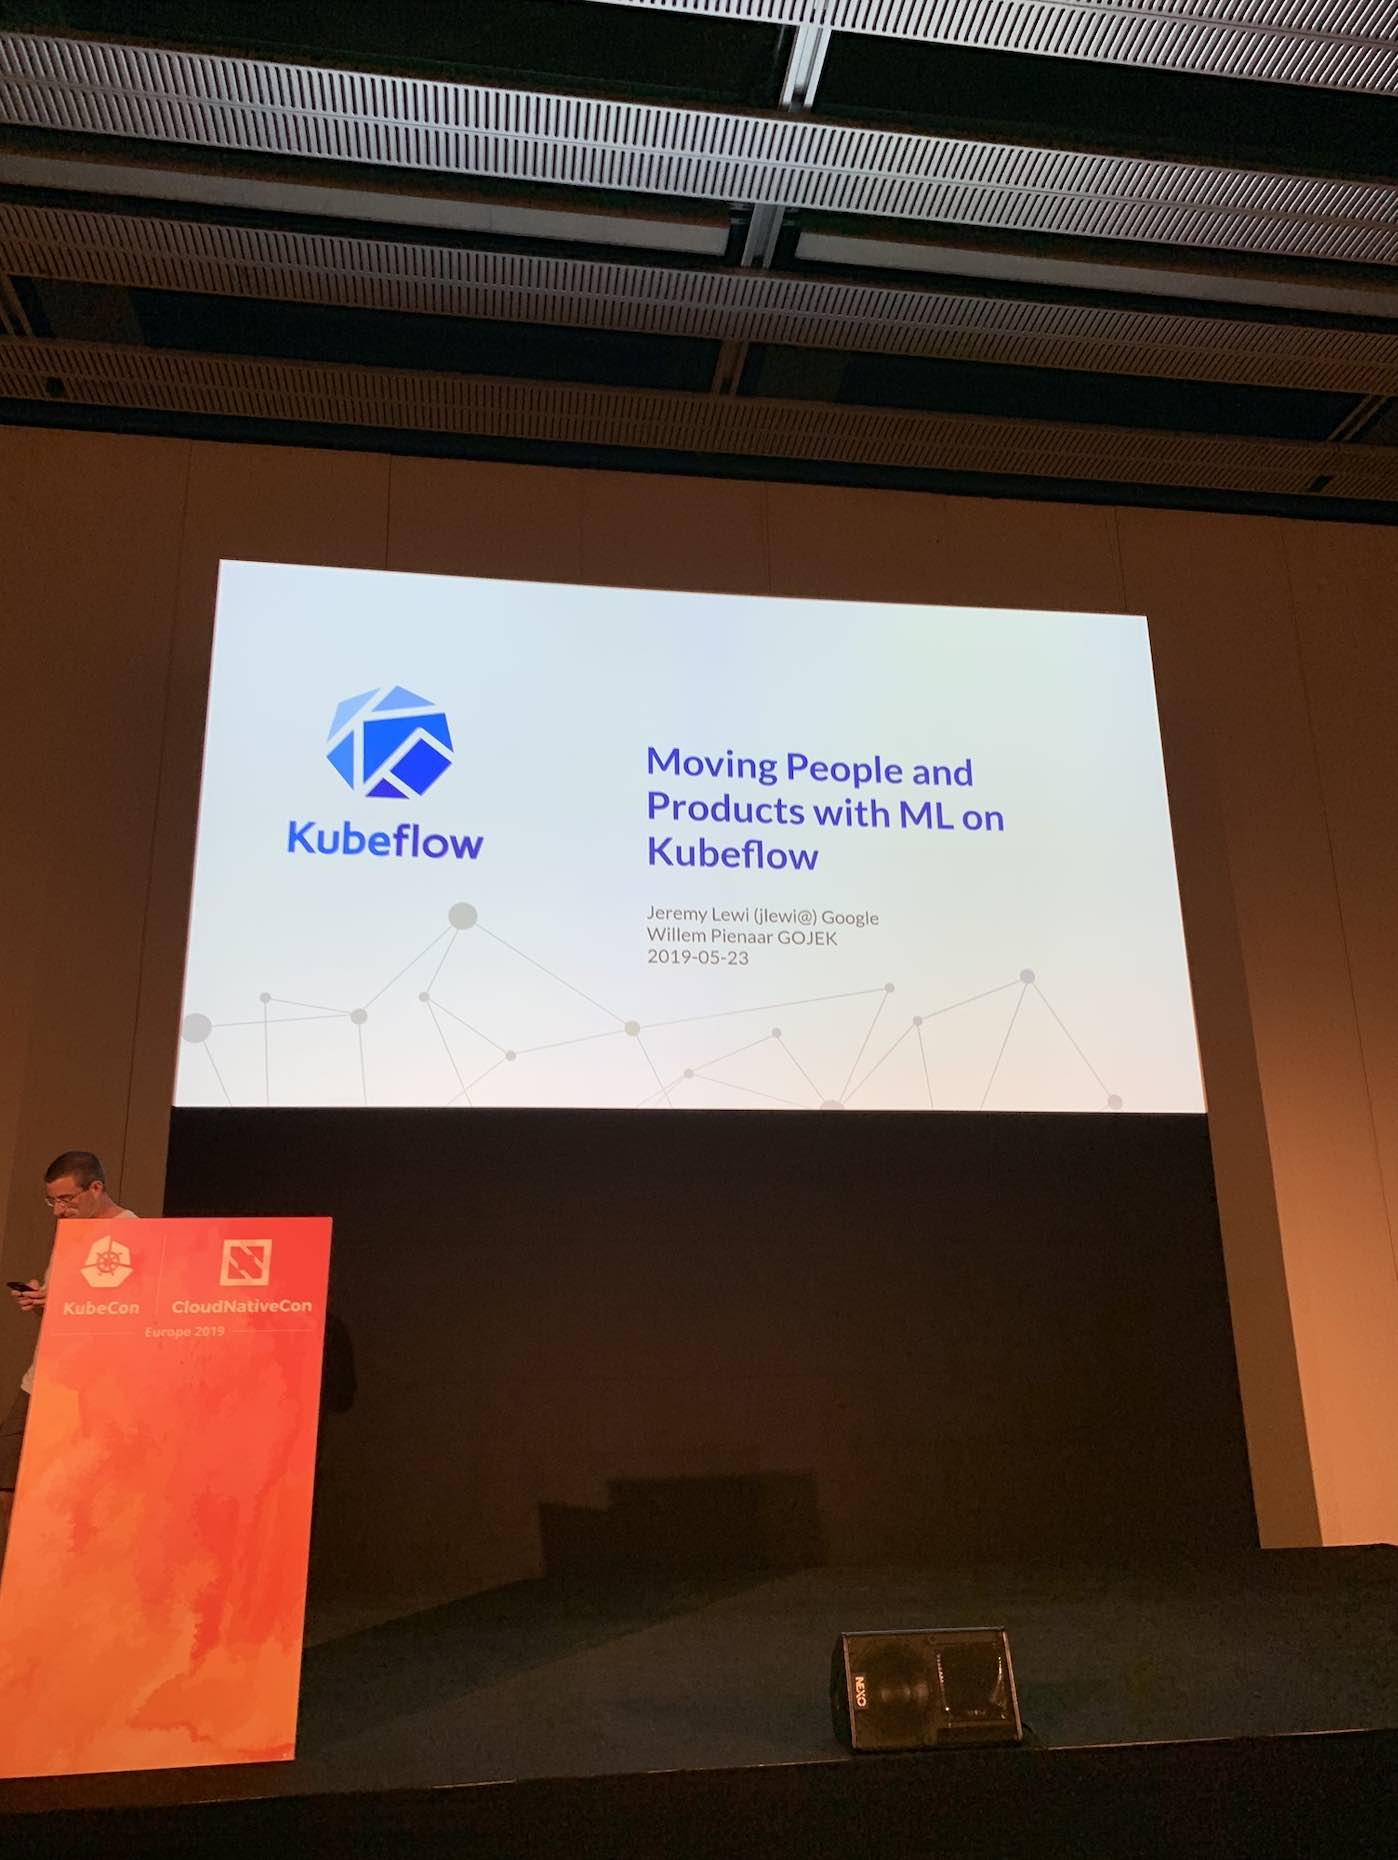
Kubeflow 의 주 개발자는 화면에 보이는 구글의 Senior S/W Engineer 인 Jeremy Lewi 다. 당시 저 발표는 간단한 설명후에 데모 형태로 발표가 되었는데 Kubernetes 위에 Kubeflow 를 설치한 상태에서 Jupyter Notebook 을 띄어 Model 을 개발하고, Fairing 으로 Model Training 후 Model Serving 하는 것을 시연으로 보여주었다.
영상은 아래를 클릭하면 볼 수 있다.
https://www.youtube.com/watch?v=-GYiatVNemY

저녁에 Arrito 가 주최하는 Kubeflow 개발자 / 사용자와의 저녁 만남이 있었는데 거기서 Jeremy 와 이야기를 해봤을 때는 전형적인 내성적이고 약간은 고지식한 개발자라는 느낌을 받았던 기억이(물론 이건 주관적인 생각). 시간이 좀 지나니 혼자 따로 앉아 있던데.
Kubeflow 를 왜 써야 하나?
AI Platform Developer 라면 아래의 그림은 많이 봐왔을 것이다. 정 가운데에 있는 ML Code 는 데이터 사이언티스트들이 모델을 개발하는 코드인데, 이런 개발을 도와주거나 실제 서비스로 구축하기 위해서는 코드 이외에도 많은 Tool / System 들이 필요하다는 의미를 보여준다.
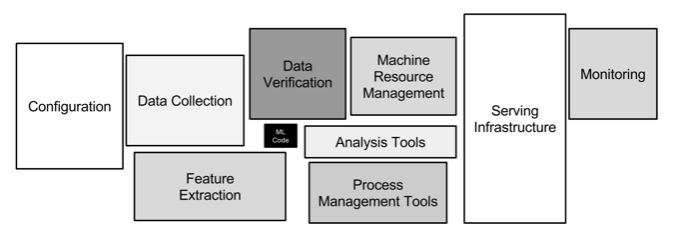
https://papers.nips.cc/paper/5656-hidden-technical-debt-in-machine-learning-systems.pdf
또한 위의 동영상에서도 아래와 같이 설명하고 있다.
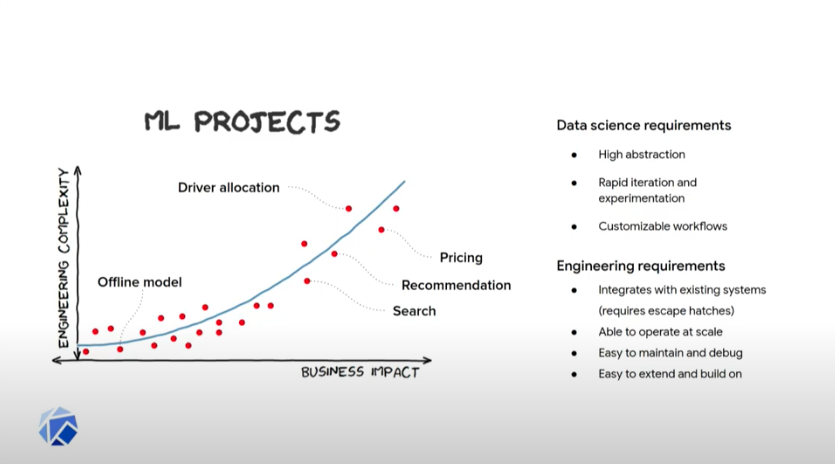
간단하게 살펴보는 Kubeflow Architecture
아키텍처에 대한 설명은 Kubeflow document 사이트를 참고하여 간단히 설명하고자 한다.
https://www.kubeflow.org/docs/started/architecture/
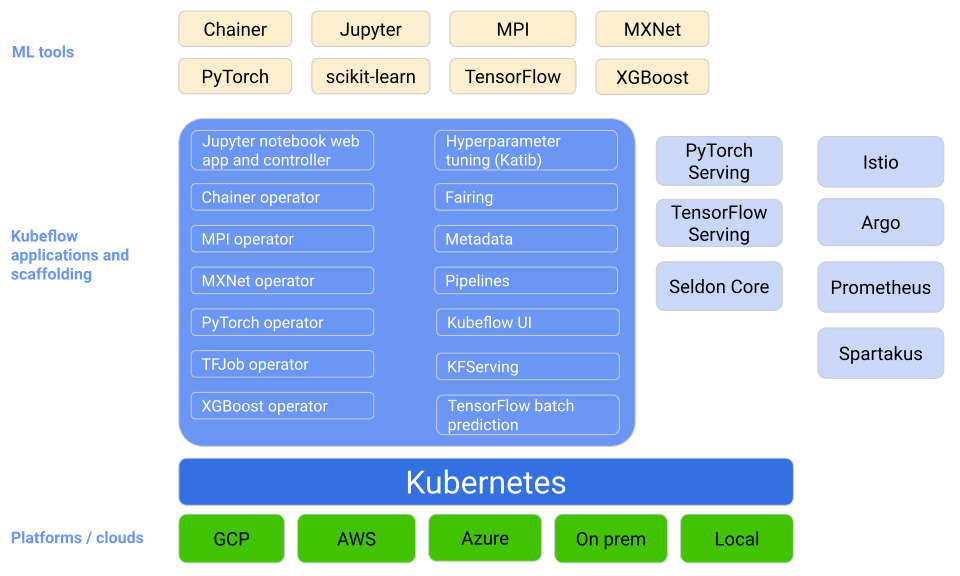
ML 개발 프로세스는 Experimental Phase (실험 단계) 와 Production Phase (운영 단계) 로 나눌 수 있으며 전체 워크플로우는 아래와 같다.
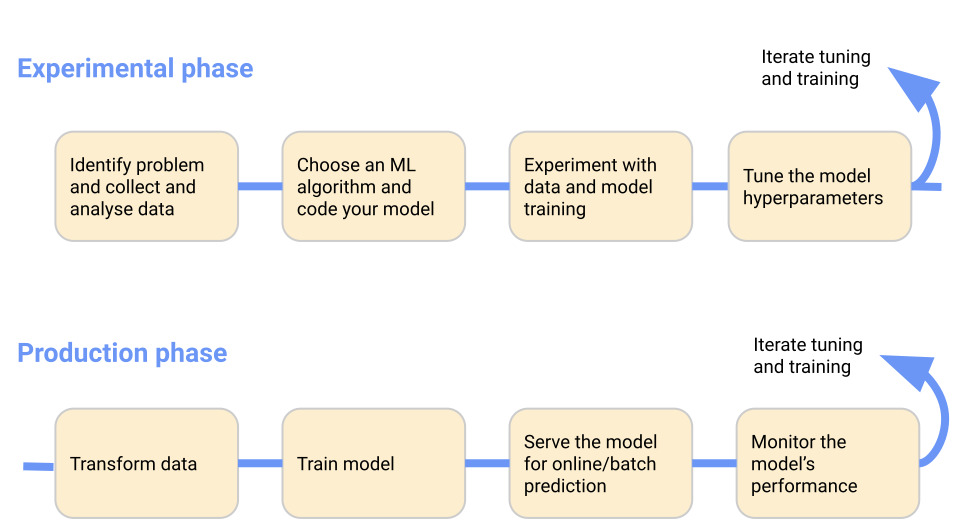
실험 단계
1. 문제를 인식하고 데이터를 수집/분석
2. ML 알고리즘을 선택하여 모델을 코딩
3. 데이터를 가지고 모델 트레이닝
4. 하이퍼 파라미터 튜닝
운영 단계
1. 데이터 변환
2. 모델 트레이닝
3. 온라인/배치 예측을 위한 모델 서빙
4. 모델 성능 측정 (결과를 가지고 다시 트레이닝하거나 튜닝)
단계에 적용되는 Kubeflow 컴포넌트는 아래와 같다.
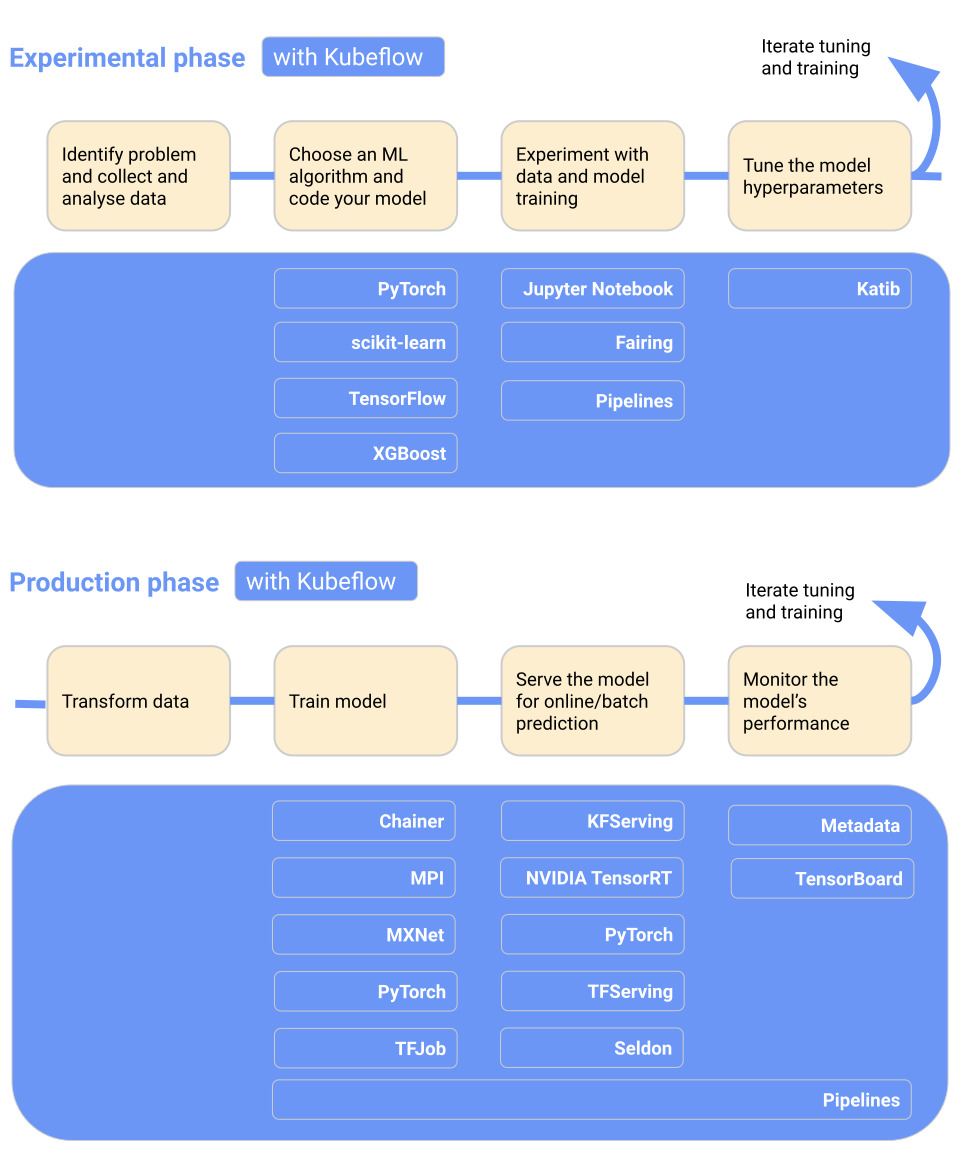
- Fairing: 위성발사를 생각해보면 로켓 맨 상단에 중요 내용물인 위성을 보호하기 위해서 Fairing 으로 감싸고 있다. 모델을 안전하게 다른 시스템으로 전달하는 기능으로 python library 를 제공한다.
- Pipelines: Argo workflow 기반으로 python library 를 제공하여 pipeline 을 구축할 수 있다. 예를 들면 데이터 전처리 등 반복되는 작업을 자동으로 수행할 수 있다.
- Katib: 하이퍼 파라미터 튜닝을 자동으로 해주는 기능이다. 아래 그림과 같이 하이퍼 파라미터를 바꾸면서 결과를 그래프와 표로 보여준다.
- KFServing: Kubeflow 에서 제공해주는 Model Serving 기능이다.
마치며
현재 Kubeflow 의 최신 버전은 v1.4 이다. 2019년 Arrito 개발자들과 만나서 논의했을 때 (당시에 v0.3 인걸로 기억한다) v1.0 으로 올리는 것이 의미있냐고 질문을 받은 적이 있다. 고객이 오픈소스의 안정성을 의심하기 때문에 기능이 조금 미흡하더라도 v1.0 으로 올리는 것이 좋겠다는 의견을 준적이 있었는데 어느덧 버전이 v1.4 까지 나왔다.(물론 그 때 이후 한참 지나서야 v1.0 이 나왔지만)
많은 기업에서 자체 AI Platform 을 만들어서 사용하는 것으로 알고 있는데, 제 개인적인 생각으로는 지금이라도 Kubeflow 로 바꾸는 것이 좋다는 생각이다. 그 이유는 이미 모두 알고 있을 것이다.
seungkyua 님의 최신 블로그
더보기-

- Kubernetes 배포 및 설정 단계별 설명
- Kubernetes 로 개발을 하다보면 이를 위한 cluster 가 하나씩은 있어야 한다. 로컬에 vm 이나 클라우드에 싱글 vm 을 받았다면 아래와 같이 kubeadm 을 활용하여 나만의 클러스터를 구축할 수 있다. 단계적으로 설정하는 방법을 설명하고 있으니 이를 그대로 따라하면 된다. 1. sudo 사용자 추가, 보안 s/w 내리기, swap off $ sudo adduser ask $ cat 〈〈 EOF | sudo tee /etc/sudoers.d/sudoers-ask ask ALL=(ALL:ALL) NOPASSWD:ALL EOF $ sudo systemctl stop ufw $ sudo systemctl disable ufw $ sudo systemctl...
-
- OpenLab - Deep Dive Kubernetes 7번째 마지막 스터디
- 벌써 마지막 스터디네요. 처음 쿠버네티스의 기본 개념과 활용법을 스터디하고, ArgoCD 를 활용한 GitOps CD 를 공부하고, Go 언어와 커스텀 컨트롤러를 거쳐서, Kubeflow 까지 왔습니다. 7/16(화)에는 OpenLab - Deep Dive Kubernetes 스터디 7번째 마지막 모임이 있었습니다. 이번 스터디 주제는 Kubeflow 의 활용법 입니다. Kubeflow 의 기능은 다양한데, 대표적인 기능이 Pipeline 을 활용한 workflow 만들기와 Katib 를 이용한 hyperparameter tuning, 그리고, KServe 를 활용한 모델 서빙이 있습니다. 오늘은 위 3가지를 모두 공부했습니다. 1가지만 해도 2시간 이상은 필요한...
-
- OpenLab - Deep Dive Kubernetes 6번째 스터디
- 안녕하세요. 7/2(화)에는 OpenLab - Deep Dive Kubernetes 스터디 6번째 모임이 있었습니다. 이번과 마지막 7번째 스터디 2회에 걸쳐서 Kubeflow 에 대해서 공부합니다. 이번 스터디 주제는 Kubeflow 설치 및 대시보드 띄우기입니다. Kubeflow 는 많은 컴포넌트로 구성되어 있어 설치하는 것만도 쉽지가 않습니다. 그래서 이번에는 Kubeflow 를 설치하고 화면을 직접 접속해 보는 것을 스터디 주제로 정했습니다 물론, 다음 마지막 스터디에서는 Kubeflow 를 어떻게 활용하는지 활용 방법과 기능에 대해서 살펴볼 예정입니다. 금번 스터디 내용은 아래와 같습니다. Kubeflow Kubeflow 설치하기 KServe 설치하기 (...
-
- OpenLab - Deep Dive Kubernetes 5번째 스터디
- 안녕하세요. 지난 6/17(월)에는 OpenLab - Deep Dive Kubernetes 스터디 5번째 모임이 있었습니다. 이번 모임으로 벌써 스터디의 2/3 가 지났네요. :) 이번 스터디 주제는 지난번 스터디의 연속인 custom controller 만들기 두번째 입니다. 지난번 스터디가 Custom Controller 를 만들기 위한 Go 언어에 대한 스터디 였다면, 이번에는 Kubebuilder 로 직접 Go 언어 코드 프로그래밍을 해보는 시간이었습니다. 금번 스터디 내용 Kubebuilder https://book.kubebuilder.io/ kubebuilder 아키텍처 살펴보기 controller-runtime 은 무엇인가? kubebuilder 로...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.