
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Multi-modal 감정 인식 AI 모델 개발 - 연구결과(3)

- DEVOTEE 요약
- SKT AI Fellowship 3기 Cycling Hit 팀은 한국어 및 영어로 멀티모달 감정 인식 연구를 진행했으며, 4가지 기본 감정 클래스를 이용한 모델을 개발했습니다. 연구과정에서 트랜스포머 기반의 멀티 모달 모델 및 파라미터 공유 방식 등을 활용하여 감정 인식의 정확성을 높였습니다. 저희 연구의 성능을 입증하기 위해 다양한 데모와 실험을 진행했으며, 연구 결과를 통해 한국어와 영어 모두 좋은 성과를 거둘 수 있었습니다.
SKT AI fellowship 3기 Cycling Hit 팀입니다! 벌써 마지막 포스팅을 올리게 되었네요. 색다른 방법으로 한국어 멀티모달 감정인식에 접근하였고 영어 멀티모달 감정인식 연구도 진행하였습니다. 이번 포스팅에서, 저희 팀의 구체적인 모델링을 공개하도록 하겠습니다! 재밌고 신기한 데모도 많이 준비했으니깐 기대해주세요.!
- 연구계획(1) 블로그 참조 : https://devocean.sk.com/blog/techBoardDetail.do?ID=163238
- 연구과정(2) 블로그 참조 : https://devocean.sk.com/blog/techBoardDetail.do?ID=163343
4 Emotion Class – Happy / Angry / Neutral / Sad
연구 초기에는 부정(Negative) / 중립 (Neutral) / 긍정 (Positive) 총 3가지 클래스에 대해서만 감정 인식 분류를 진행했었는데요. 중간 발표 이후에는, 행복(기쁨) / 분노(불안) / 슬픔(우울) / 중립 총 4가지 클래스에 대해서 감정 인식 분류를 진행하였습니다.
AI Hub 멀티 모달 영상 AI데이터셋에는 기쁨, 슬픔, 분노, 놀람, 공포, 경멸, 혐오, 중립에 관한 총 8종의 감정 라벨링이 있는데요. 이 중에서 최종적으로 4가지 클래스를 선택한 이유는 인간이 선천적으로 느끼는 “기본 정서 (Basic Emotion)”를 가장 뚜렷하게 구분 지어 나타내기 때문입니다. 러셀이 제시한 러셀 모델은 인간의 선천적인 정서를 정규화하는데, 아래 왼쪽 그림과 같이 활성화 축과 정서가 축을 통해서 기본적인 감정을 평면모형에 나타내고 있습니다.
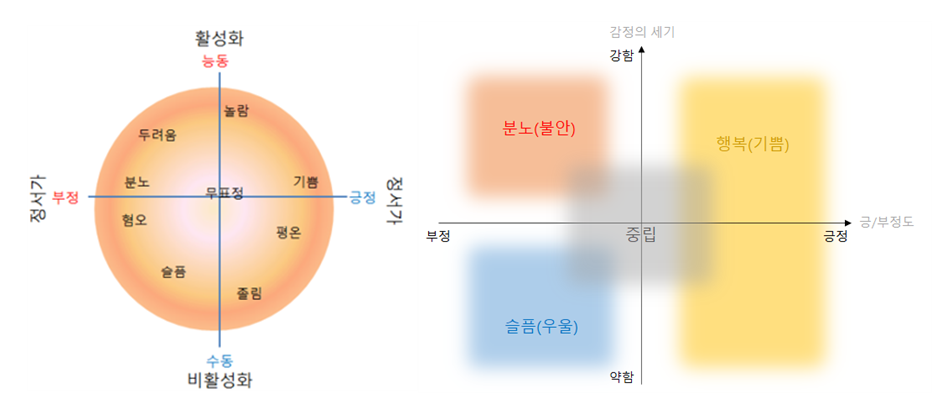
실제로 감정은 세분화하면 끝없이 세분화되고, 서로 다른 감정 간의 경계가 모호한 것들이 많습니다. 저희가 선택한 4가지 클래스에서, 행복(기쁨)은 제1 사분면과 제4사분 면에 걸쳐있고, 분노와 슬픔은 각각 제2 사분면과 제3사분 면에 나타납니다. 또한 중립 클래스의 경우, 원점 주변에 분포됩니다. 이처럼 해당 4가지 클래스는 확실히 구분됨과 동시에, 평면 전체에 걸쳐서 모든 감정을 아우르기 때문에 적절한 클래스 조합이라고 생각됩니다.
Proposed Model
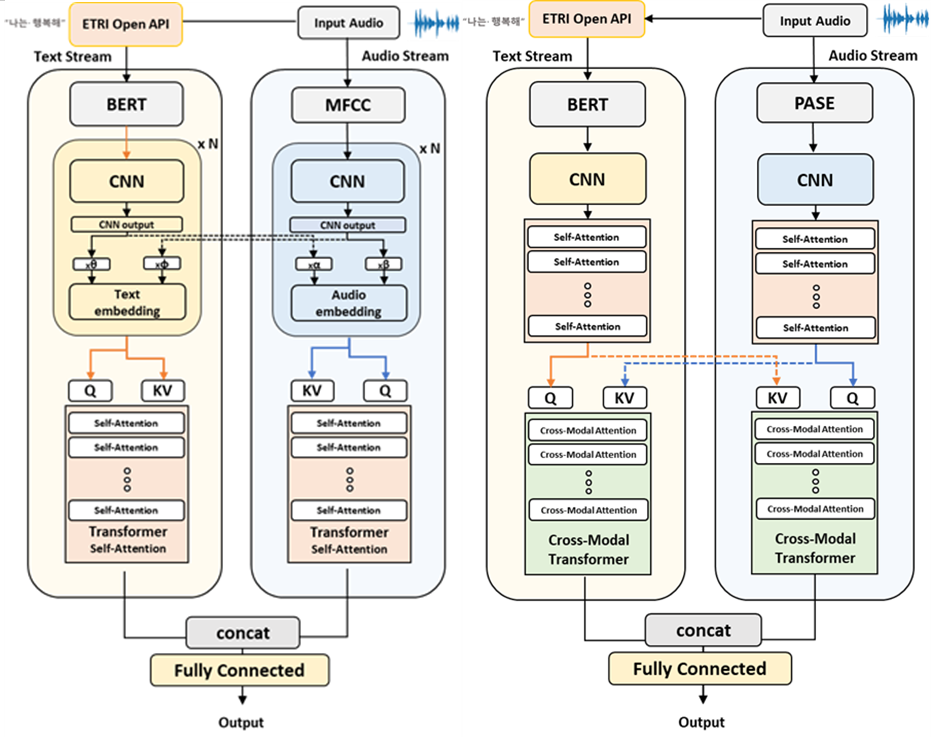
저희는 트랜스포머 기반의 멀티 모달 모델을 구성하였습니다. 저희가 참고한 Khare, S. Parthasarathy and S. Sundaram, "Self-Supervised Learning with Cross-Modal Transformers for Emotion Recognition," 2021 IEEE Spoken Language Technology Workshop (SLT), 2021. 논문 이외에도 다른 멀티 모달 태스크에서 Cross-Modal Transformer가 많이 사용되는 것을 확인할 수 있으며 해당 부분은 저희 모델에서도 핵심 부분이 되겠습니다.
KoBERT와 PASE를 통해서 텍스트와 음성 특징을 추출한 후, CNN를 거쳐서 두 모달리티의 차원을 맞춰주게 됩니다. 이후 두 모달리티는 각각 Self-Attention를 거치게 되는데, 이를 통해 텍스트 문장 내의 각 단어 간의 연관성 정보와 음원 내 각 시간 프레임 간의 연관성 정보를 기대할 수 있습니다. 시간 프레임별로 각각 감정을 예측하는 것이 아니라 음원 또는 텍스트 전체를 보고 하나의 최종 결괏값을 출력하기 때문에 해당 부분은 매우 중요하다고 판단됩니다. 같은 단어라도 다른 어떤 단어랑 조합이 되냐에 따라서 감정 상태가 달리 판단됩니다. 예를 들어서 “웃으면 행복해”에서 “행복”은 “웃으면”과 함께 강한 긍정을 보이지만, “포기하면 행복해”에서 “포기”를 해야 “행복”할 것이라는 내용은 긍정보다는 부정적인 감정을 나타냅니다.
Self-Attention을 통과한 두 모달리티는 각각 Cross-Modal Transformer의 Query, Key/Value로 활용이 되며 두 모달리티 간의 연관성 정보를 얻게 됩니다. 마지막으로 두 Cross-Modal Transformer의 Output를 Concat하여 Fully-Connected Layer를 통해서 최종 예측값을 출력합니다.
이외에도, Multi Task Learning에서 주로 사용되는 Parameter Sharing 기법을 기반으로 한 모델 네트워크를 구성해보았습니다. CNN를 인코더 부분으로 활용하는데, CNN Block을 통과할 때마다 두 모달리티 임베딩 간에 Parameter Sharing을 적용하여 특징을 공유하게 되며 연관성 정보를 획득합니다. 이후, CNN 인코더의 Output은 각각 Self-Attention Layer를 통과한 이후, Concat하여 최종 예측값을 출력합니다. Parameter Sharing을 사용한 방식이 Cross-Modal Transformer를 사용한 방식보다는 성능이 약간 떨어졌지만, 멀티모달 태스크에는 생소한 기법을 적용했다는 것에 큰 의의를 두고 있습니다.
Regression Task
일반적으로 감정인식 분야에서는 감정 클래스 (행복, 분노, 중립, 슬픔 등)를 레이블로 사용하는 Classification Task를 다룹니다. 저희는 감정 Valence (긍·부정도)와 Arousal (적극성 세기) 값을 레이블로 사용하여 감정인식 문제를 Regression Task 관점에서 해결하는 시도를 하였습니다. 멀티모달 영상 AI 데이터셋에서 제공하는 1부터 10까지의 정수 Valence 및 Arousal 메타데이터를 타깃값으로 사용하였고. Mean Squared Error Loss를 적용하였습니다.
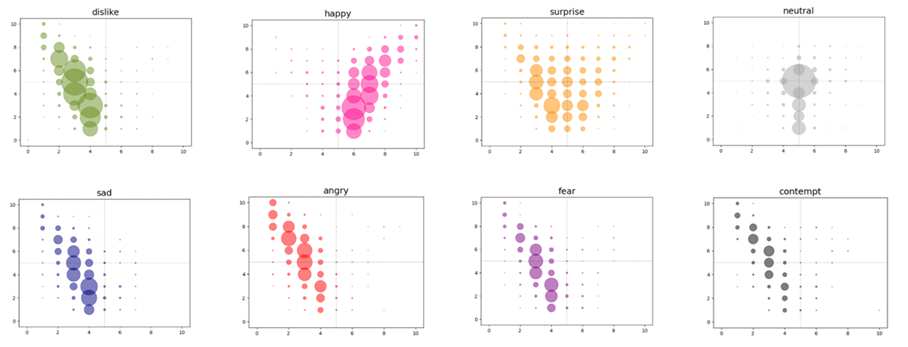
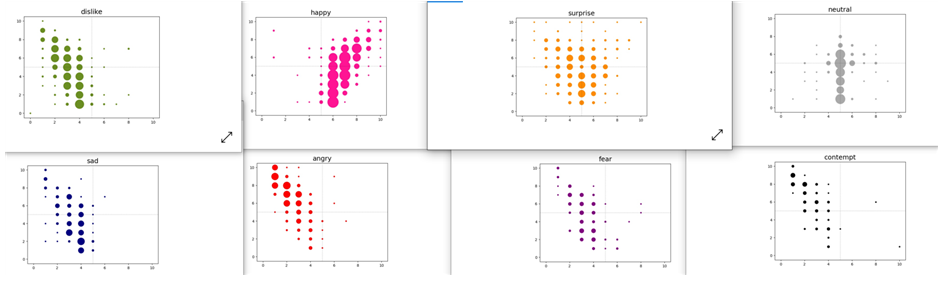
앞에서 소개한 러셀이 제시한 감정 모델에서 x축과 y축은 각각 Valence와 Arousal을 나타냅니다. 아래 그림은 멀티모달 영상 AI 데이터셋에서 감정 클래스별로 데이터의 Target Valence 및 Arousal 값을 평면에 나타낸 것입니다. 실제로 Happy 데이터는 1, 4 사분면에 Clustering이 형성되었으며, Angry, Sad 등의 부정적인 감정은 2, 3 사분면에 Clustering 된 것을 확인할 수 있습니다. 또한, Neutral의 경우는 원점에 Clustering 되었으며, Surprise의 경우 평면 전체에 걸쳐서 분포되어 있습니다. Regression Task에서 학습한 모델의 Output 결과를 평면에 Mapping 했을 때 Target과 비슷한 Clustering을 보이는 것을 목표로 연구를 진행하였습니다.
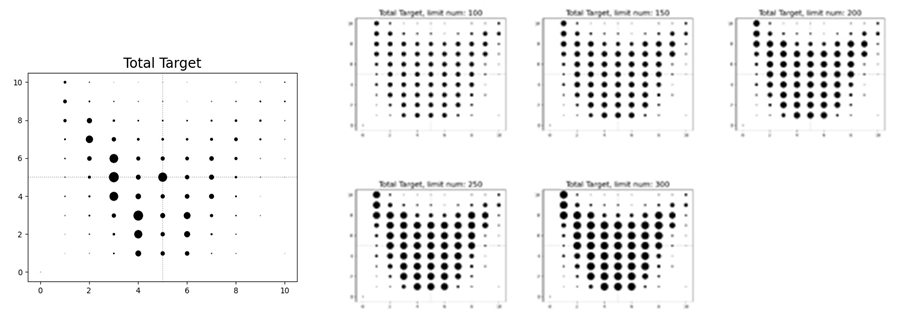
왼쪽 아래 그림과 같이 멀티모달 영상 AI 데이터셋 8만여 개의 [valence, arousal] 수는 포인트별로 Unbalance 합니다. 이를 모두 학습에 사용하는 경우, 다수의 데이터가 존재하는 포인트에 치중되는 학습을 하므로 각 포인트에 대한 데이터 수에 제한을 두는 방식으로 Data Balance를 맞추었습니다. 포인트별 Data Limit 수는 100, 200, 300, 500, 1000으로 설정하여 실험을 진행하였으며, Data Limit를 크게 잡을수록 좋은 성능을 얻었습니다. 즉, 학습에 사용되는 데이터 수가 많을수록 Regression 모델의 성능이 높아졌습니다.
Regression 모델이 예측한 Validation Data의 Arousal과 Valence 값을 Mapping 해보면 아래 그림과 같이 감정 클래스별로 Clustering 된 것을 확인할 수 있습니다. 러셀 모델 및 타겟 분포도와 비교하였을 때 비슷한 성향을 보이므로 정성적으로 좋은 성능을 증명하였다고 볼 수 있습니다.
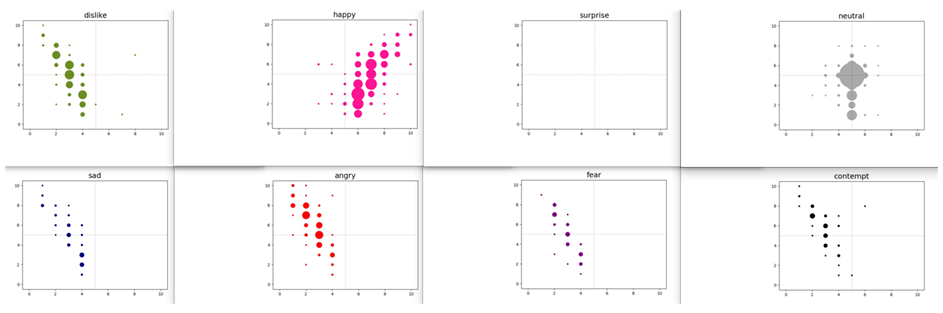
아래 그림은 Classification Task에서 모델이 예측한 감정 클래스별로 해당 데이터의 Target Valence/Arousal 값을 Mapping 한 것입니다. 이 또한, 각 감정 클래스별로 Clustering 된 것을 확인할 수 있습니다. (Reminder: Surprise 클래스는 Classification Task에서 사용하지 않았습니다.)
Regression 모델의 성능을 정성적으로 증명하였으니, 정량적으로도 확인할 필요가 있겠죠? 정량적인 결과는 아래와 같이 정리하였습니다. 모델의 Output과 Target의 차이가 각각 1, 2, 3 이하면 맞았다고 간주하고 정확도를 계산해보았습니다. Arousal보다는 Valence에 대한 정확도가 비교적 높았으며, 학습 데이터의 수를 많이 사용할수록 성능이 향상되었습니다.
Valence Accuracy
| data limit | below 1 | below 2 | below 3 |
| 100 | 33.85% | 64.09% | 84.56% |
| 200 | 38.43% | 69.93% | 88.02% |
| 300 | 42.27% | 71.42% | 89.82% |
| 500 | 43.71% | 73.16% | 90.09% |
| 1000 | 49.31% | 79.45% | 93.51% |
Arousal Accuracy
| data limit | below 1 | below 2 | below 3 |
| 100 | 26.92% | 56.85% | 79.68% |
| 200 | 29.88% | 57.33% | 81.72% |
| 300 | 32.15% | 61.38% | 84.60% |
| 500 | 29.54% | 61.75% | 85.73% |
| 1000 | 33.67% | 65.09% | 87.65% |
English Benchmark - IEMOCAP
중간 발표 이후에 저희는 모델의 성능을 보다 General 한 Benchmark로 다른 여러 연구와 비교해보고자, 영문 발화에 관한 감정인식 연구도 진행하였습니다.
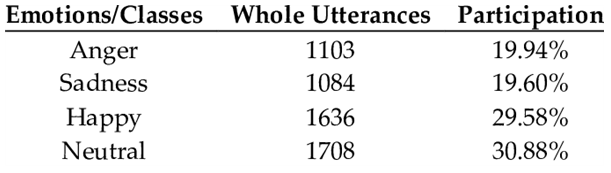
우선, 사용 Dataset 에 대한 설명을 먼저 드리겠습니다. 영문 감정인식에 주로 사용되는 Dataset 은 IEMOCAP (The Interactive Emotional Dyadic Motion Capture Database)로, 12시간 분량의 발화를 비디오, 음성, Motion Capture of Face, Text Transcriptions 형태로 제공합니다. 이 중에서 저희는 연구 목적에 맞게 음성 데이터와 텍스트 스크립트를 사용하였습니다. 원본 Dataset 은 8개의 클래스에 대한 데이터가 포함되어 있지만, 앞서 저희가 정한 주요 감정 [Angry, Happy, Sad, Neutral]에 대하여 4가지 클래스 Classification으로 학습을 진행하였습니다. 실제로, 이전에 IEMOCAP를 사용한 대부분의 연구는 해당 4가지 클래스만을 사용하여 진행하였습니다. Train 및 Test Dataset 구성도 다른 연구들이 주로 사용한 방식을 그대로 적용하여 4290 Train Utterances와 1241 Test Utterances를 사용하였습니다. Class 별 Dataset 구성은 아래와 같습니다.
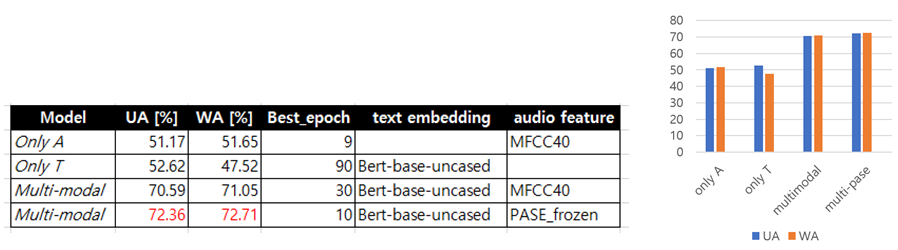
이제 저희가 구현한 모델의 IEMOCAP 데이터셋에 대한 최종 성능을 보여드리겠습니다. 이제 저희가 구현한 모델의 IEMOCAP 데이터셋에 대한 최종 성능을 보여드리겠습니다. Multimodal 모델 기준, PASE Feature를 사용했을 때 Unweighted Accuracy (UA) 72.36%, Weighted Accuracy (WA) 72.71%로 가장 좋은 성능을 보였습니다. 저희가 확인한 IEMOCAP Speech Emotion Recognition 논문들의 UA 성능이 주로 70% 후반대인 것을 보아, 어느 정도 Decent 한 성능이라고 볼 수 있을 것 같습니다.
각 클래스에 대한 Confusion Matrix 는 아래와 같습니다.
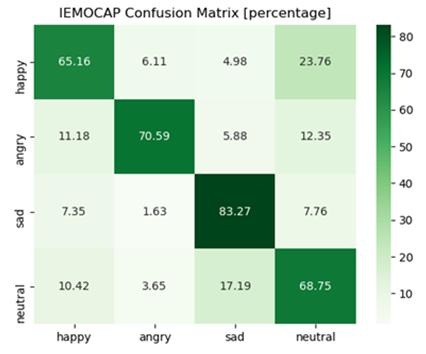
한국어 감정인식 모델로부터 영어 감정인식 모델을 구현할 때, Text Sentence Embedding을 뽑는 Model만 Ko-BERT에서 Pre-trained 영문 Bert로 교체하였는데, 이 모듈을 Roberta 등 다양한 Text Embedding 추출 모듈을 시도해보면 성능을 고도화할 수 있지 않을까 생각합니다.
Demo Video
이번에는 저희가 3가지 데모를 준비해보았습니다.
첫째는, 한국어를 활용한 긍·부정도 Classification 모델입니다. 아래 그림은 저희의 준실시간 데모 시스템을 나타낸 그림인데, 정해진 길이 (그림에는 0.5sec으로 되어있지만 실제로는 1sec 단위로 진행했습니다) 만큼 새로운 입력 데이터를 받아서 STT 및 감정인식을 진행합니다.
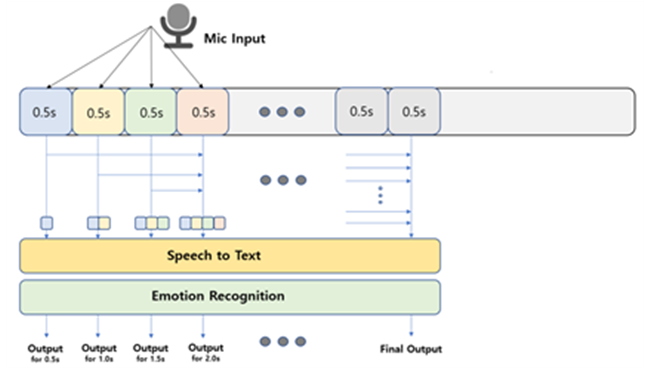
데모는 1초마다 실시간 입력을 누적해서 inference 하는 방식으로 진행되기 때문에, 감정 결과가 중간에 바뀔 수 있습니다. 아래 데모는 “힘들었지만 보람차다”와 “피곤하지만 행복해” 처럼 문자 내용에 ‘반전’이 있는 경우입니다.
2차 포스팅에서는 저희가 멀티모달 감정인식 데모만 보여드렸었는데요. 이번에는 Multi-modal, Text-only, Audio-only 모델에 관한 결과를 동시에 나타내어 보았습니다. 아래 데모를 통해 유니모달에서는 틀렸지만, 멀티모달에서는 맞추는 경우를 확인해보세요!
두 번째 데모는 한국어 Regression 모델입니다. 모델의 valence 및 arousal 값을 평면상에 찍는 형태로 데모를 진행했습니다. 행복(기쁨), 분노, 슬픔을 오가면서 연기를 펼치는데, 평면에 찍히는 좌표를 주의해주세요!
세 번째는, 영어를 활용한 4가지 감정 클래스 Classification 모델입니다. 부족한 발음은 귀엽게 봐주세요.....ㅎ
감사의 글
프로젝트 기간 동안 많은 관심과 도움을 주신 김창현 멘토님, 이상율 멘토님, 송인지 멘토님 진심으로 감사드립니다. 많은 걸 배우고 느끼면서 즐겁게 연구를 할 수 있었습니다. 옆에서 항상 큰 도움 주신 박하은 멘토님, 이민정 멘토님께 감사의 말씀 드립니다. 부족하지만 관심 있게 읽어주신 모든 분께 감사드립니다. 사이클링히트 화이팅!
davidshlee47 님의 최신 블로그
더보기-

- Multi-modal 감정 인식 AI 모델 개발 - 연구결과(3)
- 안녕하세요. SKT AI fellowship 3기 Cycling Hit 팀입니다! 벌써 마지막 포스팅을 올리게 되었네요. 색다른 방법으로 한국어 멀티모달 감정인식에 접근하였고 영어 멀티모달 감정인식 연구도 진행하였습니다. 이번 포스팅에서, 저희 팀의 구체적인 모델링을 공개하도록 하겠습니다! 재밌고 신기한 데모도 많이 준비했으니깐 기대해주세요.! 연구계획(1) 블로그 참조 : https://devocean.sk.com/blog/techBoardDetail.do?ID=163238 연구과정(2) 블로그 참조 : https://devocean.sk.com/blog/techBoardDetail.do?ID=163343 4 Emotion Class – Happy / Angry...
-

- Multi-modal 감정 인식 AI 모델 개발 - 연구과정(2)
- 안녕하세요.😄 2차 포스팅으로 다시 돌아온 SKT AI fellowship 3기 Cycling Hit 팀입니다! 저희는 그동안 한국어 멀티모달 감정 인식 AI 모델 개발 연구 진행에 힘을 쏟고 있었는데요. 이번 포스팅을 통해 저희가 진행한 부분에 대한 설명과 함께 데모 영상도 보여 드리고자 합니다. 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163238 Dataset Preparation 먼저 데이터셋 선정 및 전처리 가공 과정을 말씀드릴게요. 저희는 기본적으로 AI Hub 멀티 모달 영상 AI데이터셋을 사용했습니다. 110시간 17분 분량의 멀티 모달(영상, 음성, 텍스트) 데이...
DEVOTEE 추천 블로그
-

- KoBERT/KoGPT/KoBART 기반 언어처리 Application 개발 - (3) 연구결과
- 안녕하세요. 저희는 KoBERT/KoGPT/KoBART 기반 언어처리 Application 개발이라는 연구 과제에 참여하게 된 SKT AI Fellowship 3기 바른말 고운말 팀입니다. 이번 글을 통해 저희의 연구 결과을 전달 드리려고 합니다. (1) 연구계획 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163212 (2) 연구과정 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163324 1. 연구배경 및 목표 (1) 연구배경 (2) 연구목표 (3) 연구가치 2. 데이터셋 구축 (1) Hate Speech Detection 용 데...
-
- Multimodal 정신 건강 인식 프로젝트 - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하게 된 B-7 emo카세 팀입니다. 저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다. 첫 포스트에서는 Fellowship 기간동안 수행하게 될 연구의 계획과 최종 예상 결과물을 소개해 드리도록 하겠습니다. 〈목차〉 정신 건강 인식이란? 연구 배경 연구 최종 목표 연구 내용 제안 모델 데이터셋 예상 결과물 Project Plan & Team Introduction 1. 정신 건강 인식이란? 저희 팀은 현대사회에서 중요한 문제로 자리 잡고 있는 정신 건강, Mental ...
-
- B-7 Multimodal 정신 건강 인식 프로젝트 - 연구과정(2)
- 안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하고 있는 B-7 emo카세 팀입니다. 저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다. 이번 포스트에서는 현재까지 진행한 연구 진행 결과에 대한 중간 발표 내용과 멘토분들의 피드백을 반영한 앞으로의 향후 계획에 대해 이야기해보고자 합니다. 목차 예상 데모 시나리오 Main Objectives Cross-Modal Emotion Label Depression Detection 향후 계획 1. 예상 데모 시나리오 저희는 멀티모달 건강 인식 프로젝트로 대화 상황을 가정하여...
-
- 생성형 AI 기술을 이용한 보이스 피싱 탐지 기술 개발 - 연구 결과(3)
- 안녕하세요! SKT Fellowsup 6기 생성형 AI 기술을 이용한 보이스 피싱 탐지 기술 개발 과제를 진행한 피싱피싱(Phishing Fishing) 입니다. 이번 포스트에서는 최종 연구 결과를 공유하며, 저희가 문제를 어떻게 정의했는지, 어떤 접근 방식을 취했는지, 그리고 어떤 결과를 도출했는지를 차례대로 소개해 드리겠습니다. 연구 과제 소개 요즘 뉴스에서 자주 등장하는 "딥페이크"와 "보이스피싱" 이제는 단순한 화제가 아닌, 실질적인 사회적 위협으로 자리 잡고 있습니다. 특히 이 기술을 악용한 보이스피싱은 더 정교한 수법과 기술로 사람들에게 실제 피해를 주고 있습니다. 저희는 이에 효과적으로 대응할 수 있는 기술을 개발하는 것을 목표로 하고 있습니다. 영화...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.