
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
GAN으로 생성된 거짓 영상 판별 기술 개발 - 연구결과(3)
- DEVOTEE 요약
- Team 딥텍터는 지난 5개월 동안 SKT AI Fellowship에 참여하여 GAN 기반의 딥페이크 판별 모델 개발을 완료했습니다. 연구는 딥페이크, 어드버셔리얼 공격, 물리적 조건 변화에 모두 강인한 통합 모델을 만드는 것을 목표로 했으며, 최종 통합 모델은 여러 환경에서 기존 모델보다 우수한 성능을 나타냈습니다. 이를 통해 향후 B2C 서비스에 적합한 성능 향상과 실용화가 기대됩니다.
안녕하세요, Team 딥텍터 (Deeptector) 입니다.
저희는 지난 5달동안 "🦄 GAN으로 생성된 거짓 영상 판별 기술 개발" 라는 연구 과제로 SKT AI Fellowship 3기로 참여했었는데요.
11월 15일 최종 발표를 끝으로 드디어 막을 내렸습니다.
Unseen 환경을 다루는 주제였던만큼 쉽지는 않았지만 다양한 측면에서 고민하며 많은 점을 배울 수 있었습니다.
오늘 마지막 장에서 저희 팀의 최종 결과물을 공유드리겠습니다!
이전 글은 아래에서 참고해주세요!
- 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163229
- 연구과정(2) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163330
최종 연구 결과 발표에 앞서 저희의 연구 주제와 중간 발표까지의 연구 결과에 대해 간단히 먼저 요약드리겠습니다.
1. 연구 목표
저희의 과제는 GAN으로 생성된 가짜 영상, 즉 딥페이크 (Deepfake)를 판별하는 모델을 개발하는 것인데요,
그 중 에서도 저희는 "B2C 상황에서 딥페이크 판별 모델이 마주할 수 있는 다음의 어려운 상황에서도 강인한 판별을 수행할 수 있도록 개발" 하는 것에 특히 관심을 가지고 연구 목표로 삼았습니다.
1. 학습된 딥페이크 방법 이외의 방법으로 제작된 영상에서의 성능 저하 (Unseen Deepfake method)
2. Adversarial attack이 적용된 딥페이크 영상에 대한 취약성 (Adversarial attack scenarios)
3. 비디오 압축, 해상도, 밝기 등 물리 환경 변화에 따른 성능 저하 (Physical condition shift)
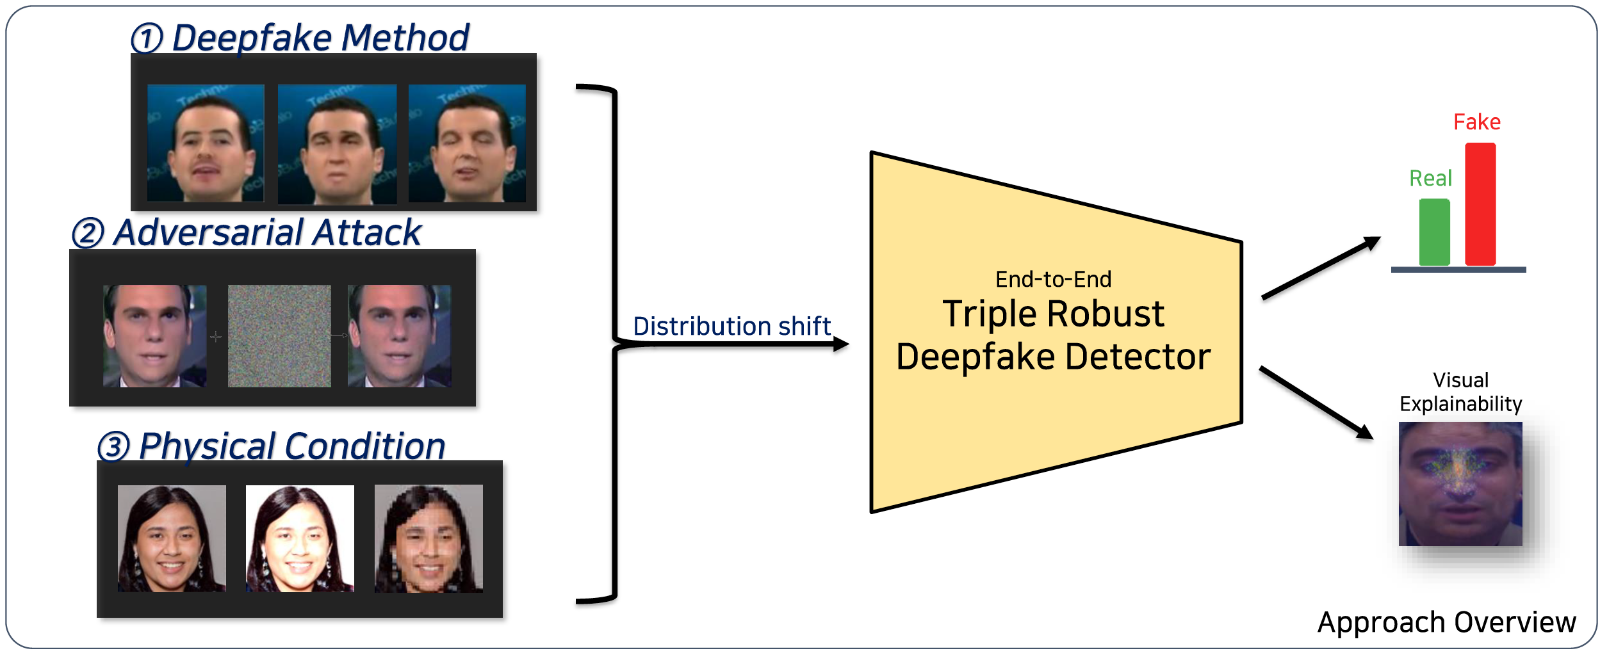
딥페이크 기술은 높은 해상도의 영상을 실제처럼 제작할 수 있는 GAN 기술과 함께 빠르게 발전하면서 유명 연예인, 정치인, 회사 CEO 뿐만아니라 심지어는 일반인을 대상으로 하는 영상이 제작되어 피싱 사기 등으로 악용될 위험이 증가하고 있습니다.
특히 이러한 딥페이크 기술이 발전하면 가장 취약한 분야는 얼굴 인식 서비스 분야인데요,
현재 상용화된 많은 얼굴 인식 기술이 딥러닝 기반의 모델을 사용하고 있기 때문에 만약 딥페이크 영상이나 Adversarial attack 등의 공격이 수반될 경우 신분을 위조하거나 시스템을 무력화 시키는 등의 보안상의 위험을 초래할 수도 있습니다.
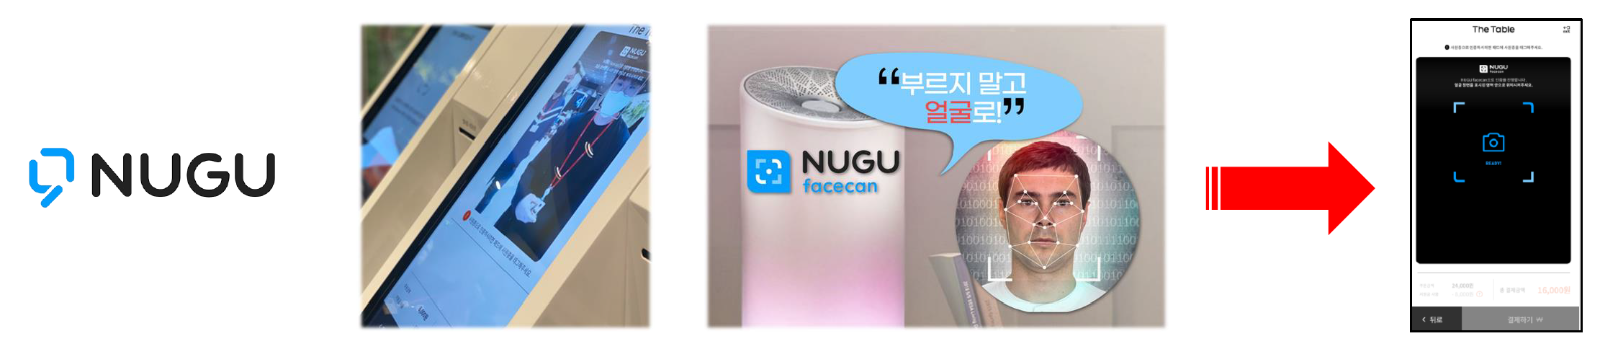
SKT NUGU facecan 얼굴 인식 기술 등 이러한 서비스를 추후 B2C로 확장하기 위해서는 이와 같은 상황에서도 강인하게 판단할 수 있는 기술이 필요합니다.
2. 중간 발표 연구 요약
저희는 위에서 언급했던 세가지 위험 상황은 모두 학습했던 데이터의 환경이 아닌 학습하지 않은 환경 변화를 대비하는 것이기에 각 파트가 하나하나가 연구 주제가 될만큼 쉽지는 않았습니다. 따라서 2달 반의 기간동안 저희 팀원들이 각자 한 파트씩 전담하여 따로 병렬개발을 수행했었고, 모든 파트에서 의미있는 성과를 이뤘었습니다. 각 파트의 아이디어와 연구 성과에 대해 간략히 요약드리면 다음과 같습니다.
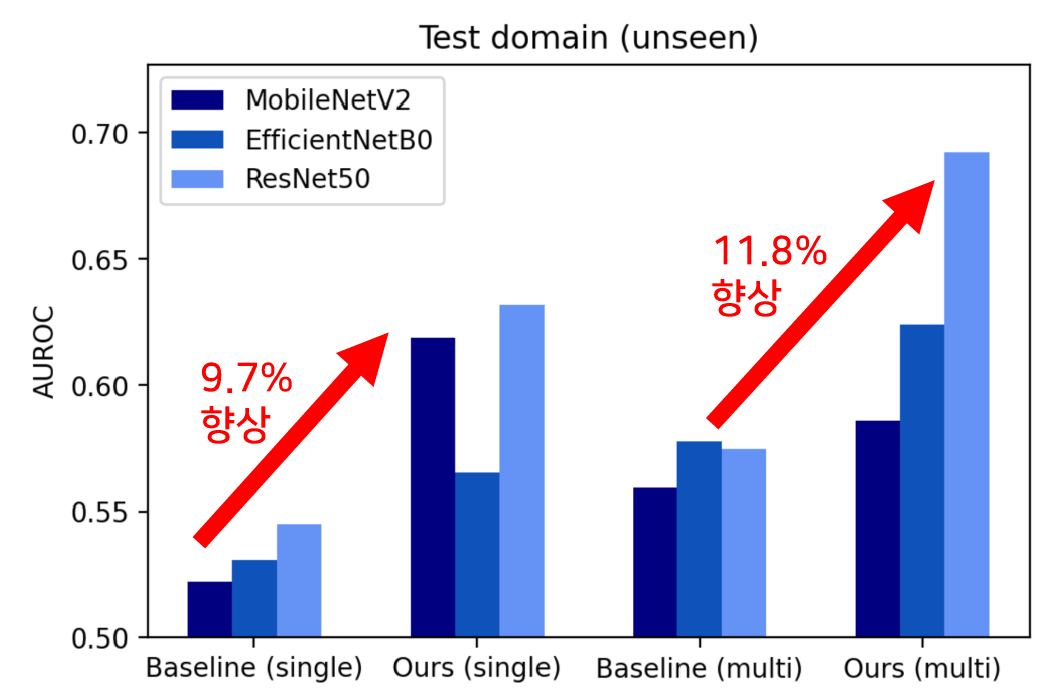
① Unseen Deepfake method robust model
- GAN으로 생성하는 딥페이크 생성 기법들이 가진 불변의 특징을 학습하고자 함
- GAN 모델이 가진 Up-sampling 모듈로 인해 실제 데이터와의 차이가 이미지의 phase 도메인에 누적되는 사실을 활용하여 흑백 이미지의 Phase 이미지를 학습 특징으로 활용
- 학습하지 않은 딥페이크 생성기법 데이터에서 baseline 모델에 비해 AUROC가 최대 11.8% 향상
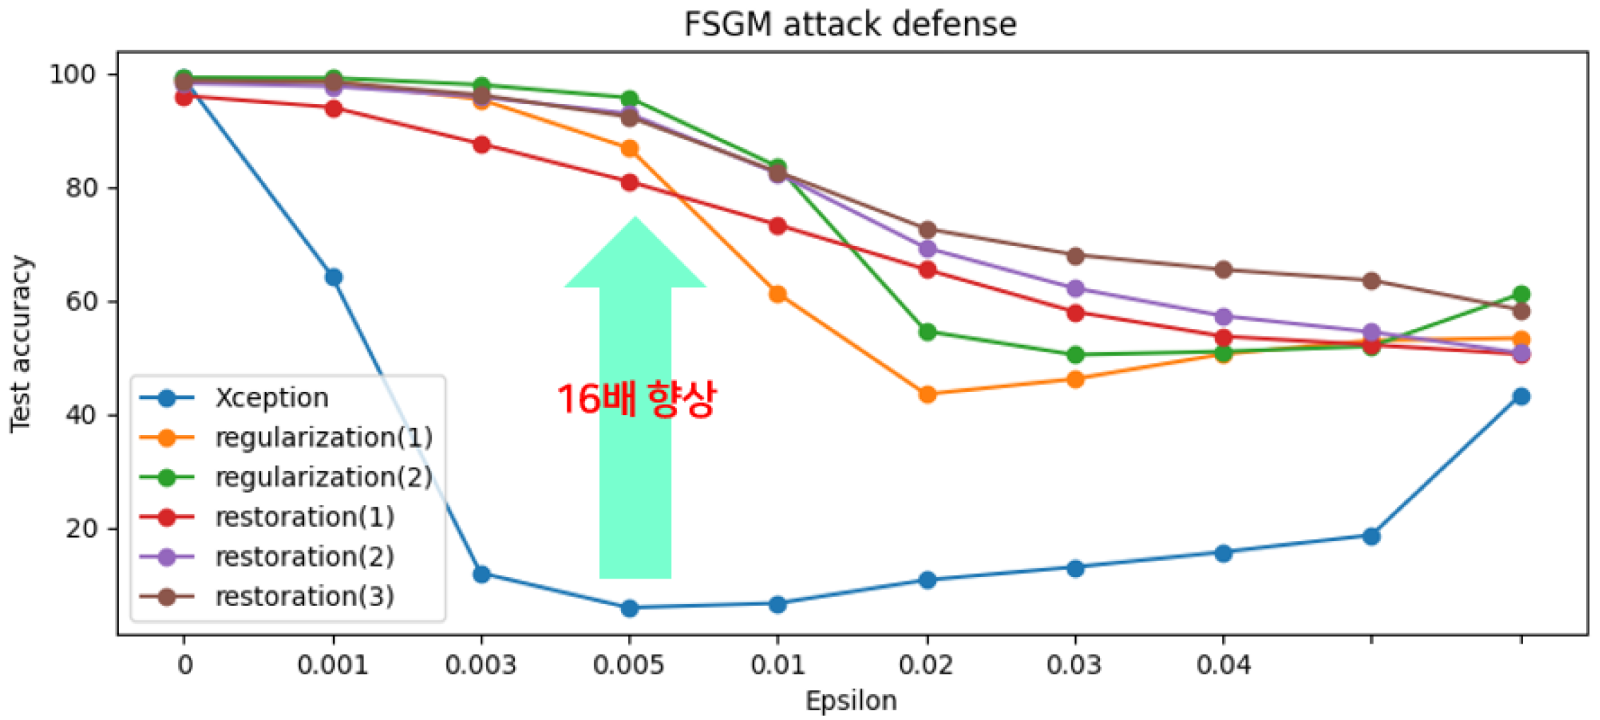
② Adversarial attack robust model
- Attack 노이즈가 추가된 이미지를 사람의 눈으로는 구별할 수 없기 때문에 모델 스스로 판별할 수 있도록 보완하고자 함
- Lipschiz regularization loss를 활용한 정규화 방법과 저희가 직접 수정한 OUDefend 모델을 사용한 이미지 복원 기법을 활용
- FGSM adversarial attack 기법에 대해 baseline 모델에 비해 최대 10배 이상 성능 향상되었으며 노이즈의 세기를 변화했을때도 비교적 강인한 성능을 유지
③ Physical condition shift robust model
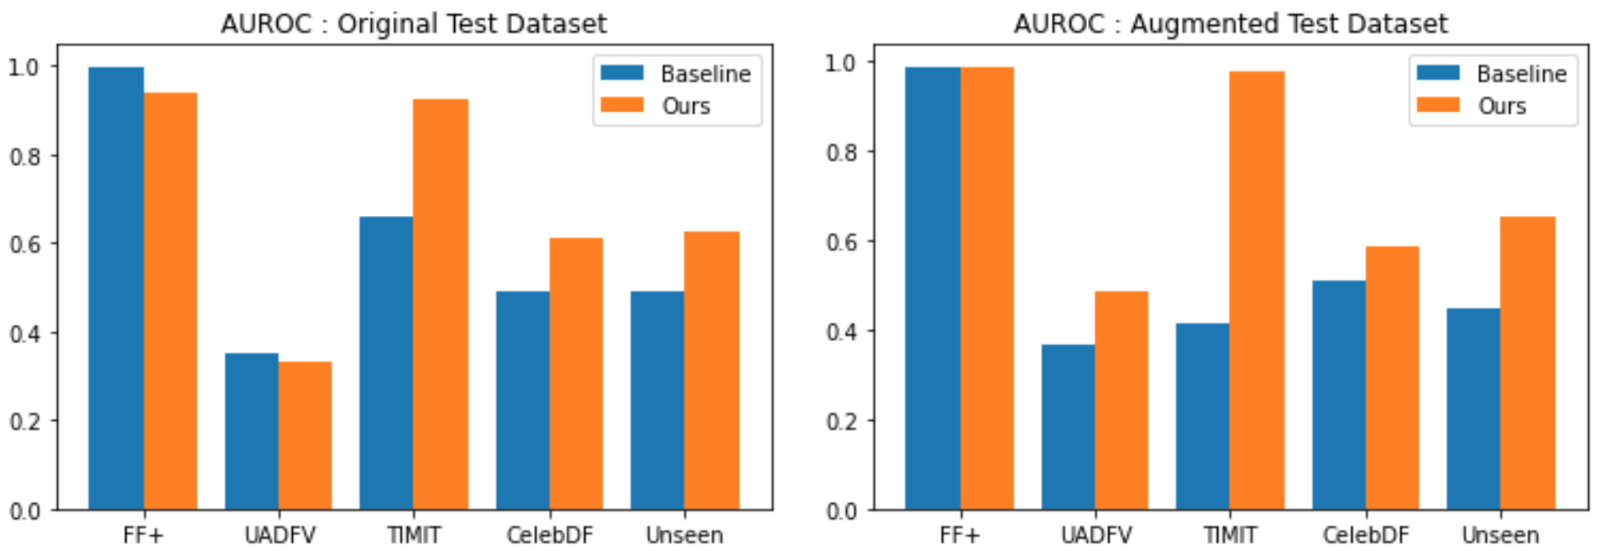
- 실사용시 수반될 수 있는 다양한 물리 환경 변화와 유사한 환경들의 특징을 최대한 학습하고자 함
- 강인한 data augmentation을 적용하여 다양한 환경 이미지를 학습하고 constrative learning을 활용한 self-supervised learning 기법으로 모델을 pre-training해 물리적 환경에 불변하는 특징을 효율적으로 학습
- Original test dataset에 대해 AUROC 성능이 26.97% 향상하였고, 특히 환경 변화를 고려한 augmented test dataset의 unseen method에 대해 성능이 최대 45.49% 향상
3. 최종 연구 과정 및 결과
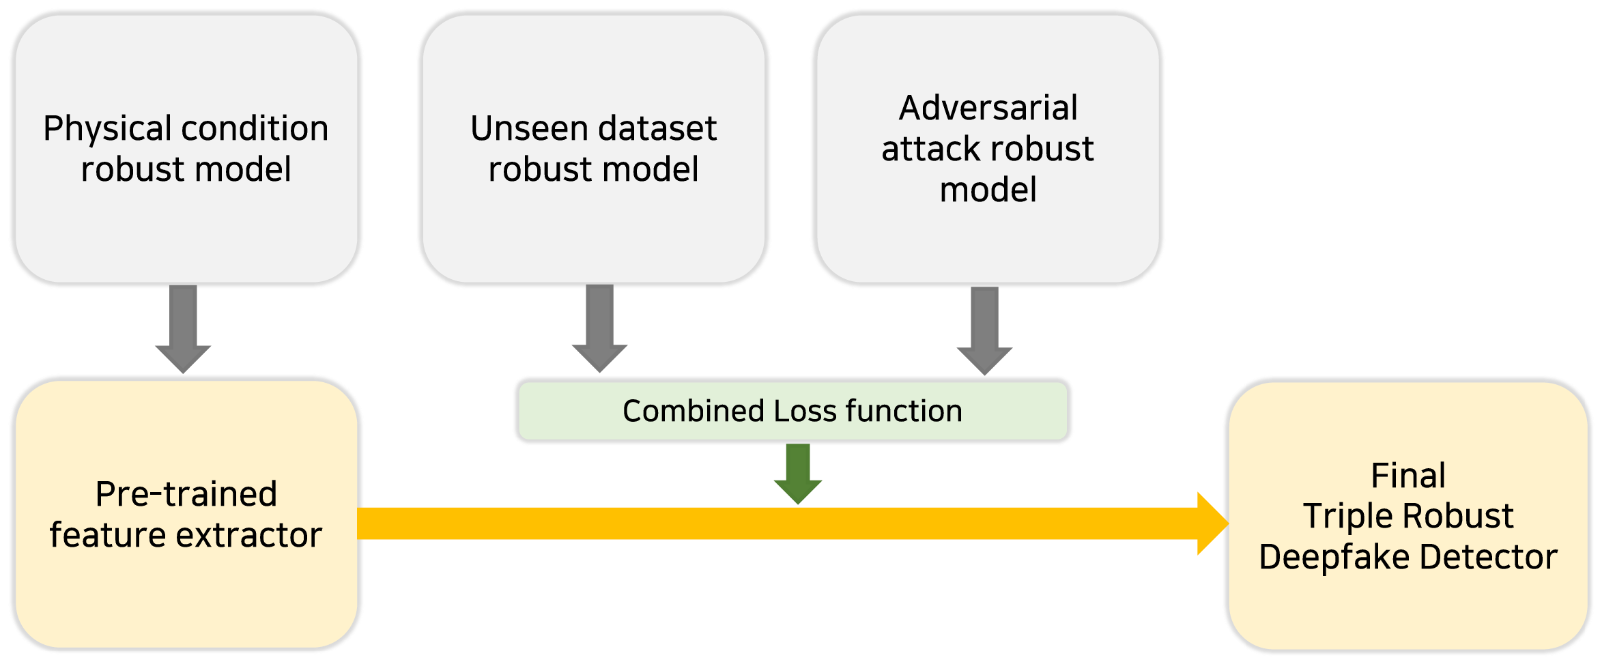
저희의 최종 연구 목표는 세가지 환경에서 모두 강인하게 동작할 수 있는 통합 모델을 개발하는 것이 였기에 중간 발표까지의 연구 과정을 종합하여 통합 모델을 개발하고자 했습니다. 이를 위해 아래와 같이 self-supervised learning으로 pre-training 된 모델을 나머지 2개 파트의 모델의 loss를 통합하여 최종 모델을 학습하고자 했습니다.
하지만 이 과정에서 다음과 같은 2가지 이슈가 발생해서 이를 해결해야 했습니다.
1) Constative learning 학습 이슈
Self-supervised learning 파트에서 모델을 연구하고 개발할 때는 작은 파라미터의 모델로 학습한 것에 반해, 통합 모델에서는 파라미터 수가 증가하면서 기존의 augmentation 만으로는 충분한 representation이 학습되기 전에 overfitting이 되버렸습니다.
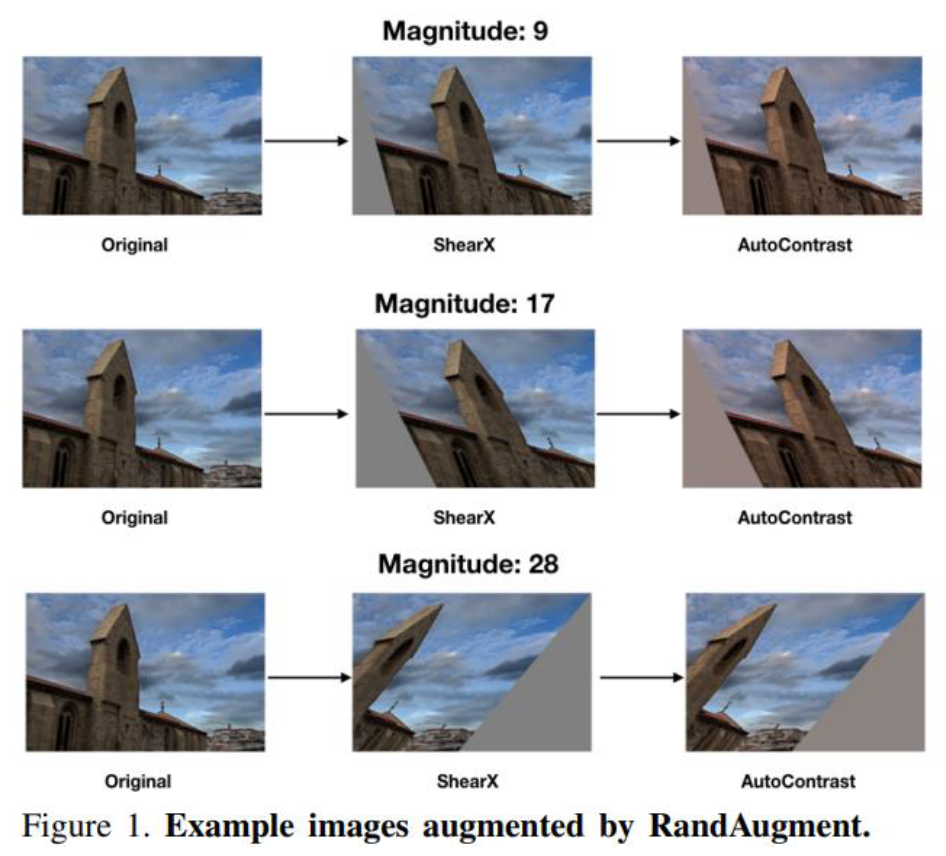
저희는 이러한 이슈를 해결하기 위해 RandAugment 라는 강력한 augmentation 기법을 추가로 적용했고 이를 통해 학습한 모델만으로도 충분한 성능을 향상을 이뤄낼 수 있었습니다.
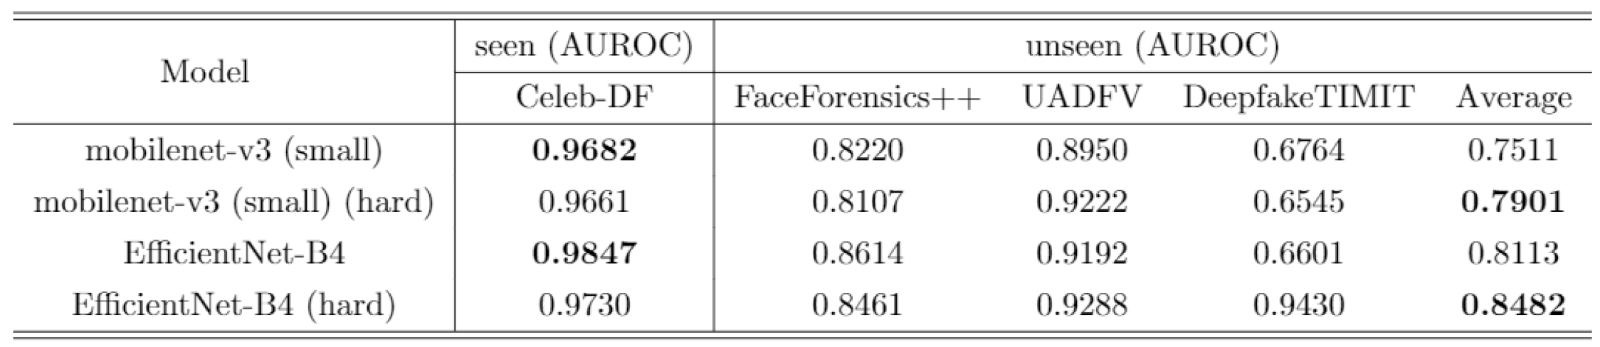
2) OUDefend 모델 학습과 통합 모델의 성능 이슈
최종 통합 모델에는 OUDefend 모델을 적용하여 adversraial attack에 대비하고자 했는데 이를 학습시키기 위해 reconstruction loss를 추가하게 되면 통합 모델의 성능이 상대적으로 낮아지는 경향이 있었습니다. 따라서 통합 모델의 성능을 높이기 위해 reconstruction loss의 영향을 최소화해서 이슈를 해결할 수 있었습니다. 하지만 이 과정에서 이미지의 복원이 제대로 이루어지지 않는 문제가 발생했지만 adversarial attack 방어 성능은 복원이 되지 않더라도 유지가 되는 경향을 보였기에 defence에 유리한 data representaion을 학습한 것으로 판단할 수 있었습니다.
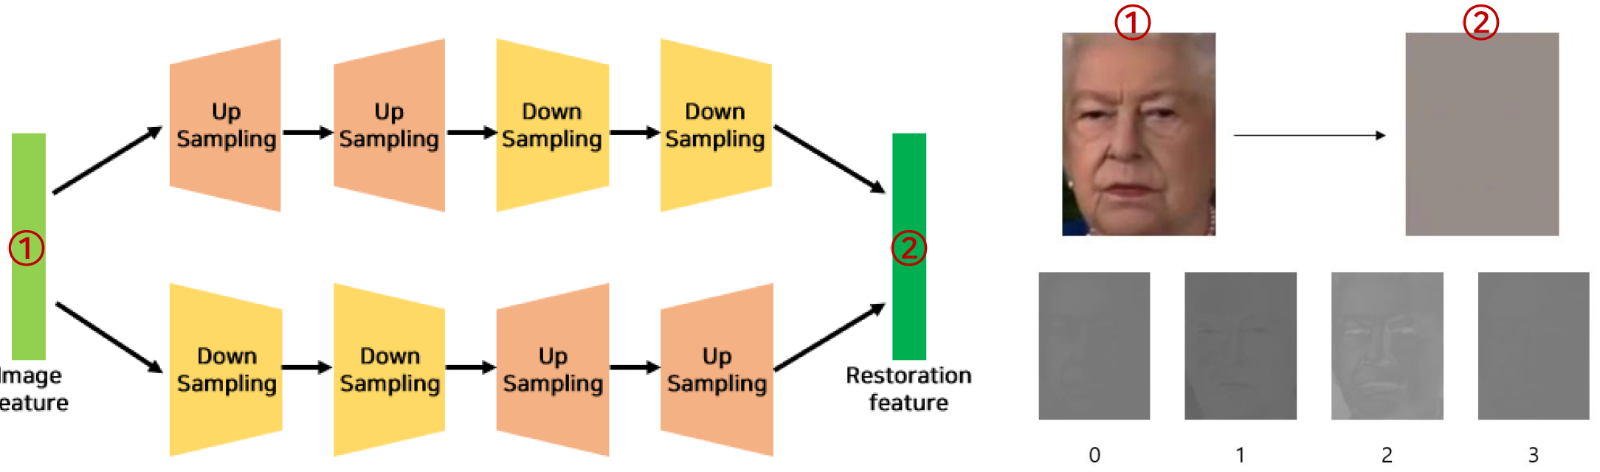
두 가지 이슈를 해결하고 난 이후에 저희는 최종 모델을 선정하기 위해 다양한 Ablation study를 수행했습니다.
1) 모델의 크기에 따른 성능 변화
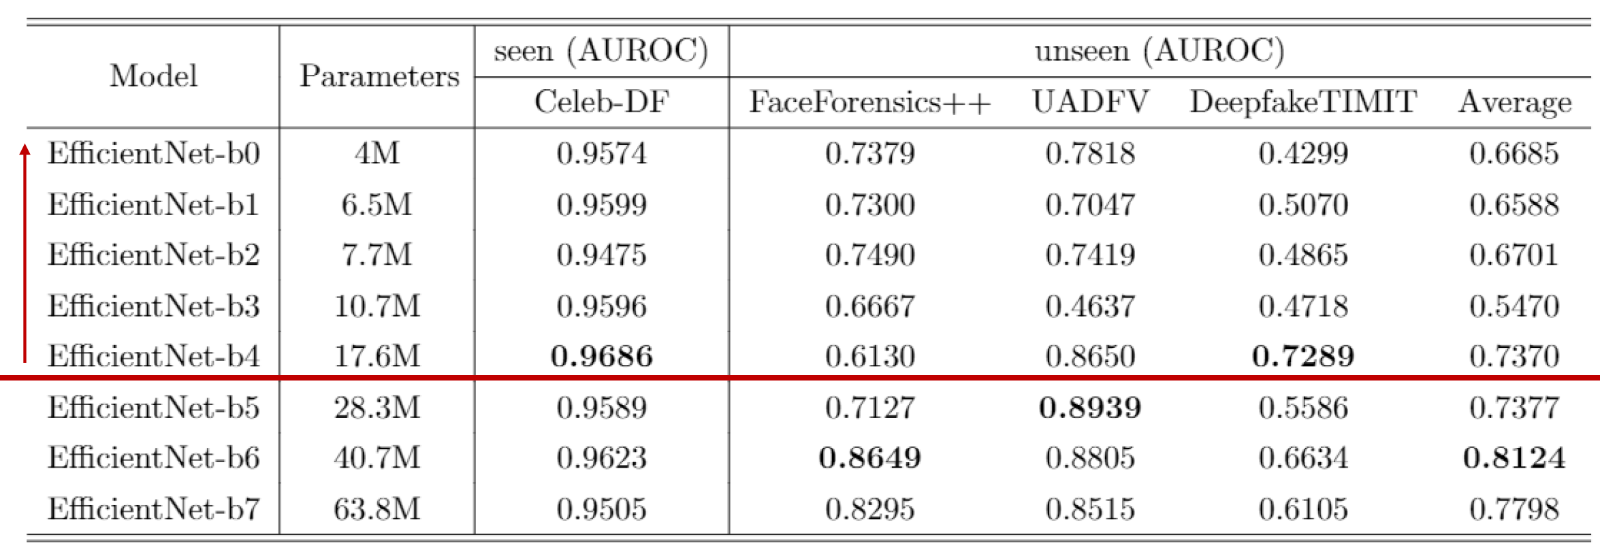
- 모델의 크기가 클수록 unseen 환경에서의 성능이 유리한 경향이 있지만, GPU 연구 환경을 고려하여 EfficientNet-B4 이하의 파라미터 수를 가진 모델을 활용했습니다.
2) 이미지 해상도에 따른 성능 변화
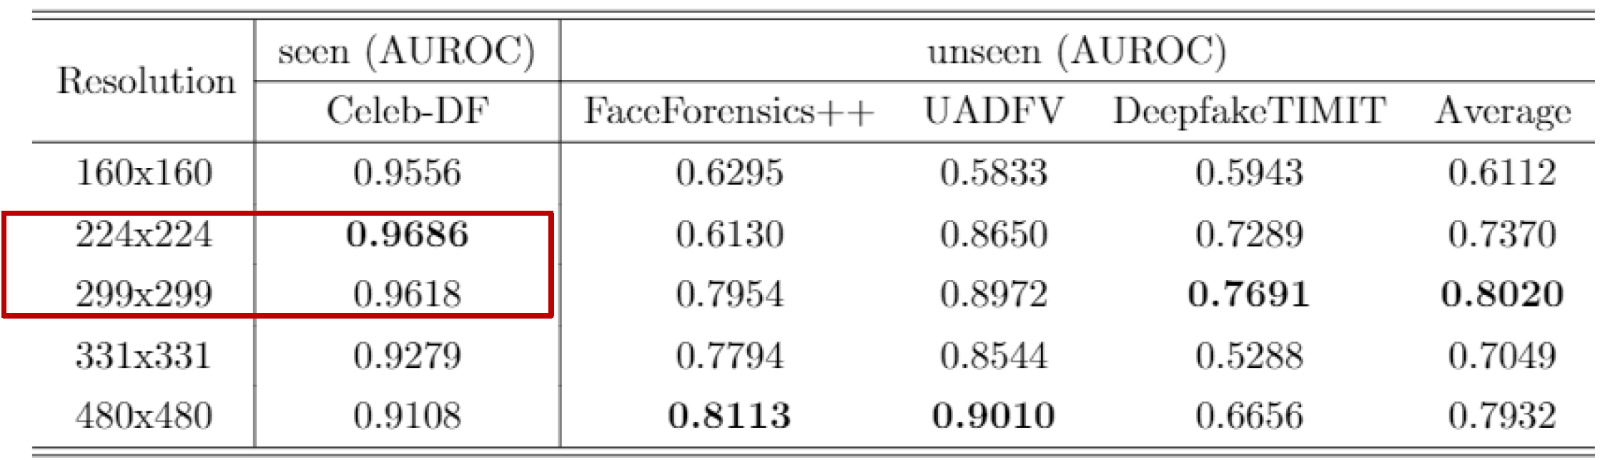
- 이미지의 해상도가 클수록 성능 상의 이득이 있지만, 통합 모델을 학습시킬 수 있고 어느정도 성능이 보장되는 해상도를 선정했습니다.
3) 모델 구조에 따른 성능 변화
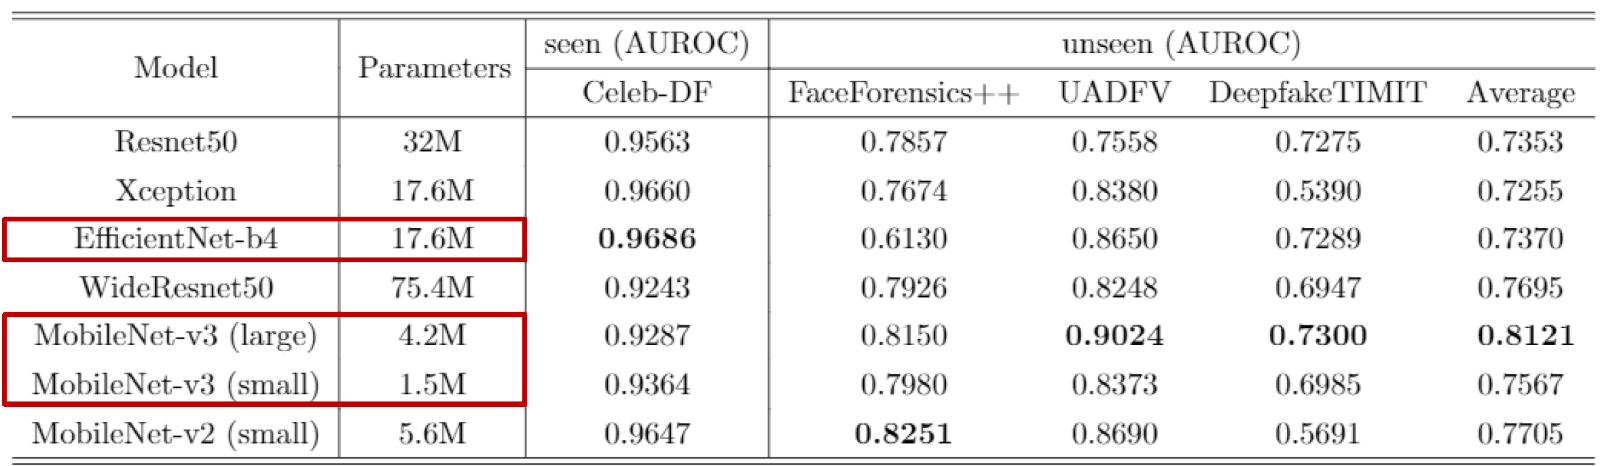
- 통합 모델에 대해 파라미터 수에 비해 EfficientNet과 MobileNet-v3가 우수한 성능을 보였습니다.
4) 앙상블 모델 활용 시의 성능상의 이득 확인
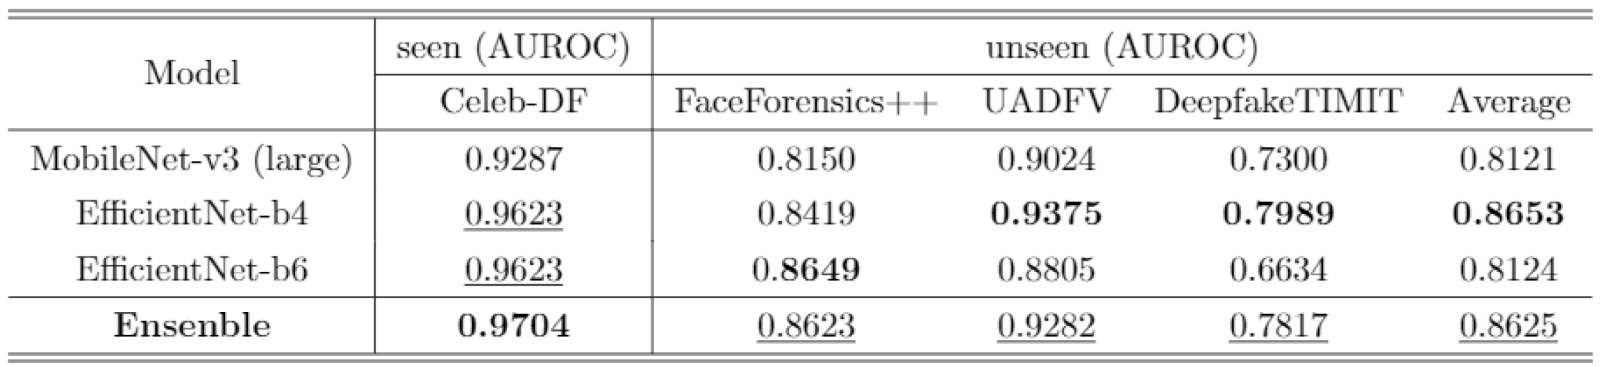
- 통합 모델학습시 unseen 방법에서의 성능은 우수하지만 baseline 모델에 비해 seen에서의 일부 성능 감소가 존재했습니다.
- 학습한 통합 모델들을 앙상블할 경우 seen에서의 성능은 사용한 모델들보다 향상될 뿐 아니라, unseen에서도 최고 성능의 모델의 수준을 유지하는 것을 확인했습니다.
저희는 위의 실험 결과를 종합하여 최종적으로 1) 서버용 모델로 활용하기 유용한 EfficientNet과 2) 모바일에서도 운용한 가능한 edge device용 모델로 MobileNetv3 을 선정하였고 224 해상도를 사용해서 최종 통합 모델 개발을 진행했고 아래와 같은 최종 결과를 얻을 수 있었습니다.
(1) 정량적 성능 평가
① Unseen Deepfake method 성능 비교
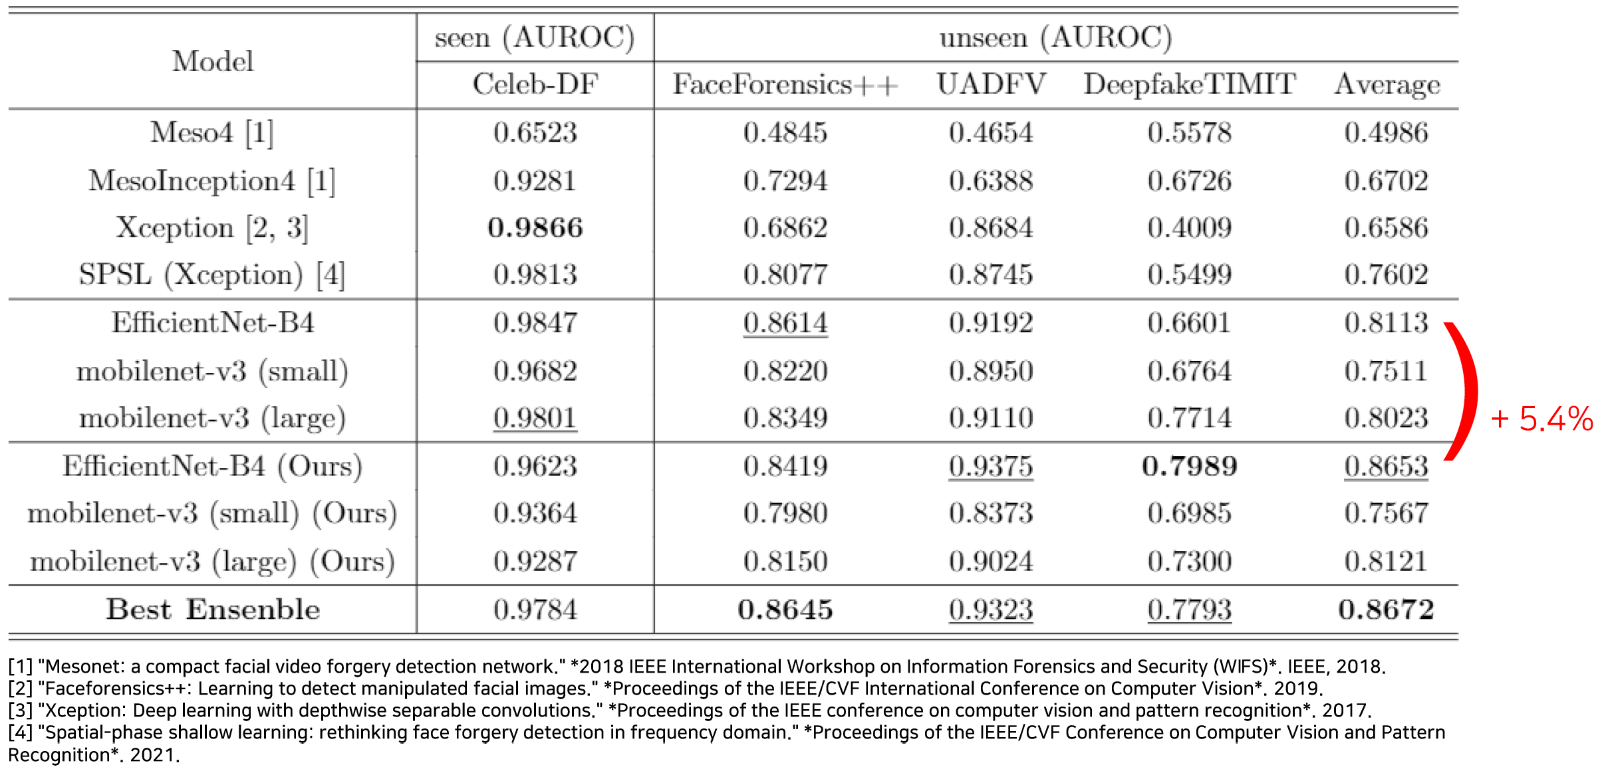
- 기존의 레퍼런스 논문들은 seen 방법에 대해서는 성능이 우수하지만, unseen에서는 성능이 크게 감소하는 경향을 보였습니다.
- unseen에서 우수한 성능을 가진 baseline 모델에 저희의 통합 모델을 적용할 경우 unseen 방법에서의 AUROC 성능을 최대 5.4% 향상 시킬 수 있었고 앙상블을 적용한 모델은 seen과 unseen 방법에서 모두 준수한 성능을 보여주었습니다.
② Adversarial attack 방어 성능 비교
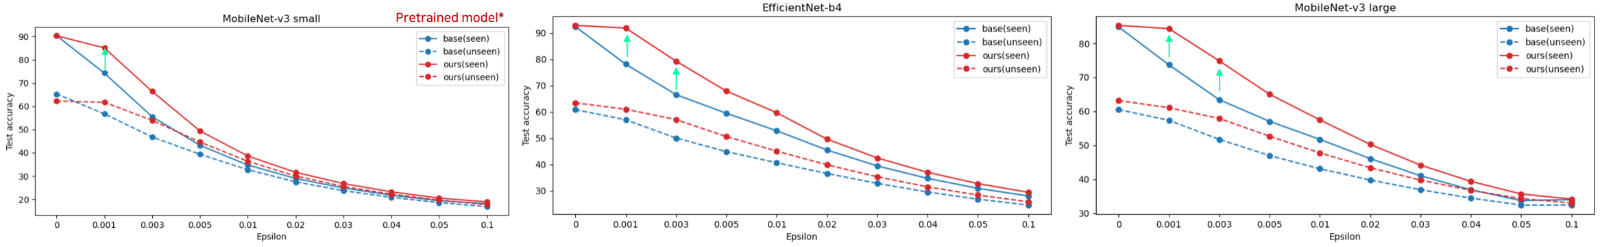
- Self-supervised learning 만으로도 adversarial attack 방어 성능이 향상되는 것을 확인할 수 있었습니다.
- 통합 모델의 fine-tunning을 통해 베이스라인과 비교하여 방어 성능이 전반적으로 향상되었습니다.
③ Physical condition shift 성능 향상 확인
- Augmented test dataset에서의 성능 비교 (gray-sacle, color jitter, rotation, etc.)
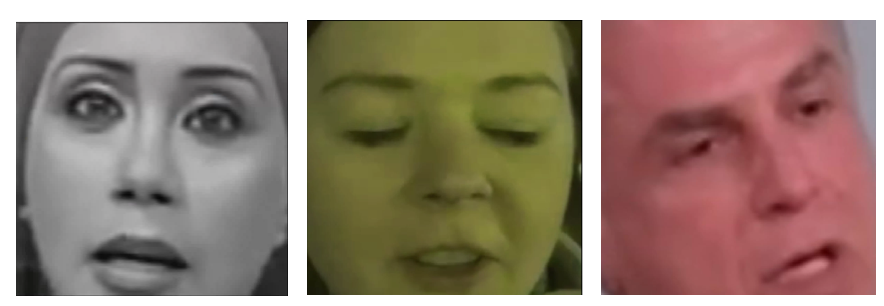
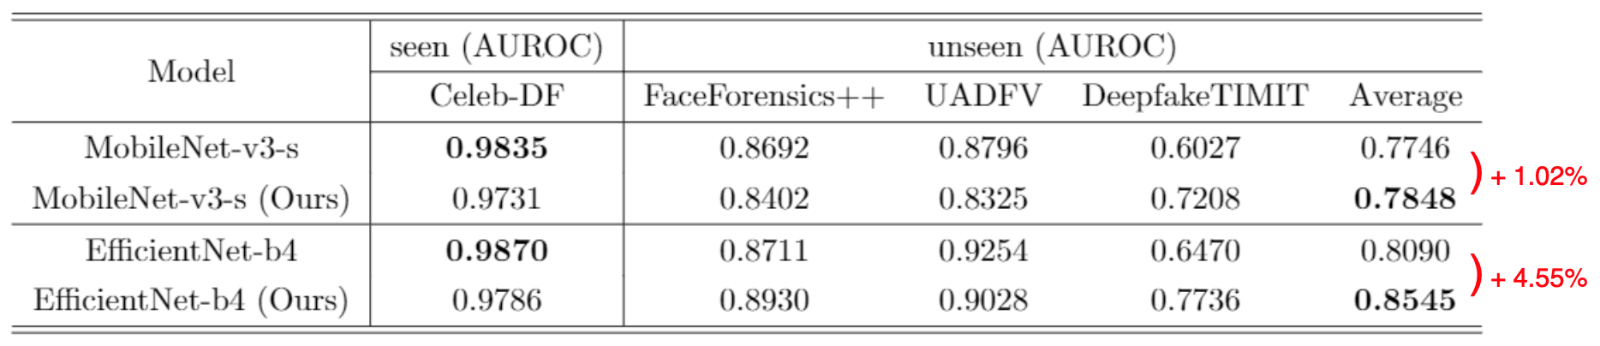
- Unseen method에서 환경 변화시 baseline 모델에 비해 AUROC 성능이 약 4.5% 향상
(2) 정성적 성능 비교
① Unseen Deepfake method 성능 비교
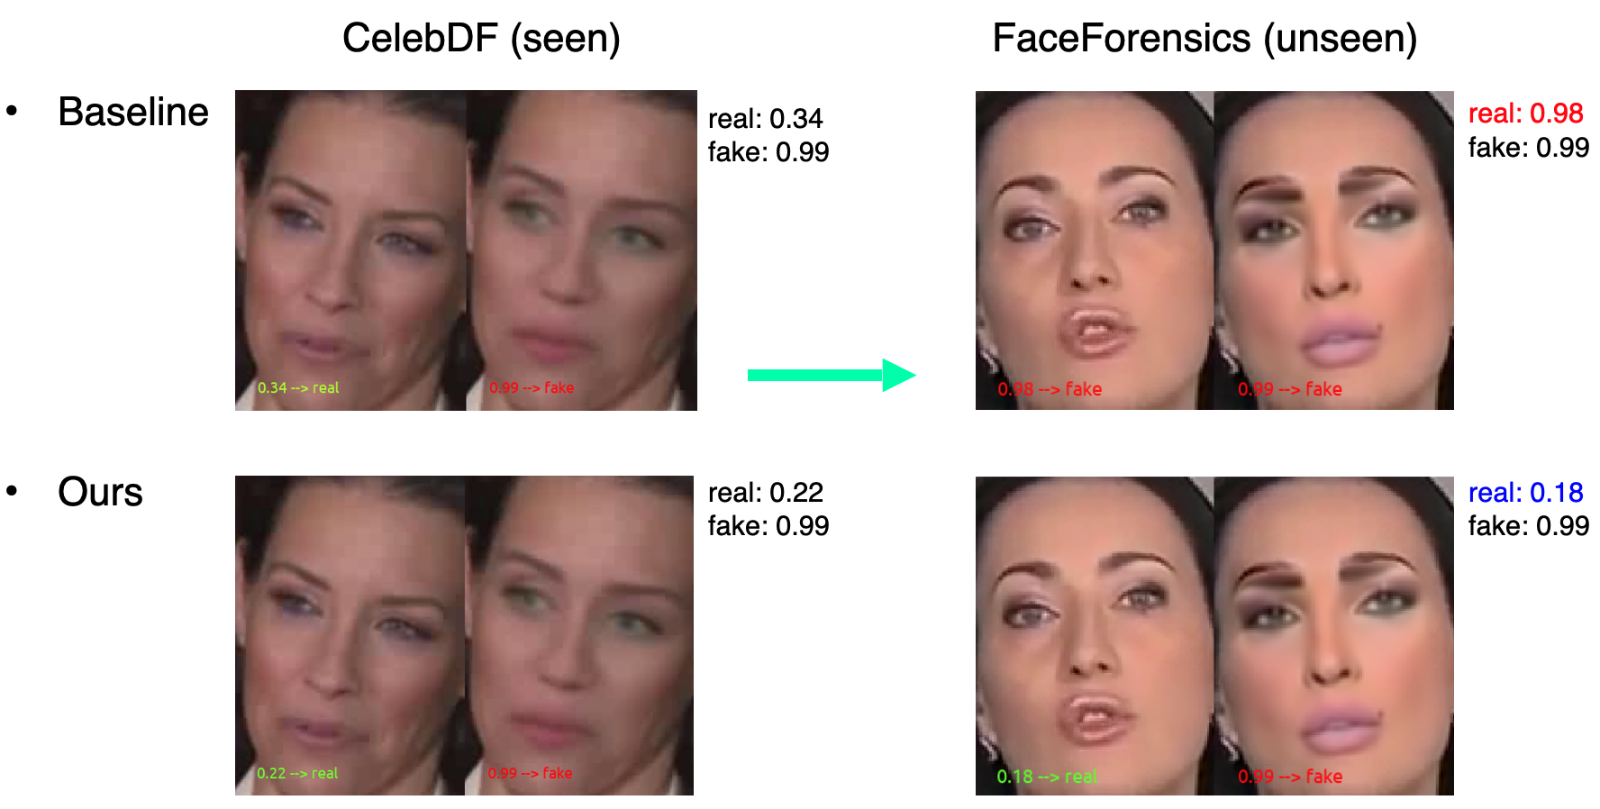
- Baseline 모델은 unseen 환경의 real 이미지를 fake로 판별하는 반면에 제안한 모델은 올바르게 판별
② Adversarial attack 방어 성능 비교
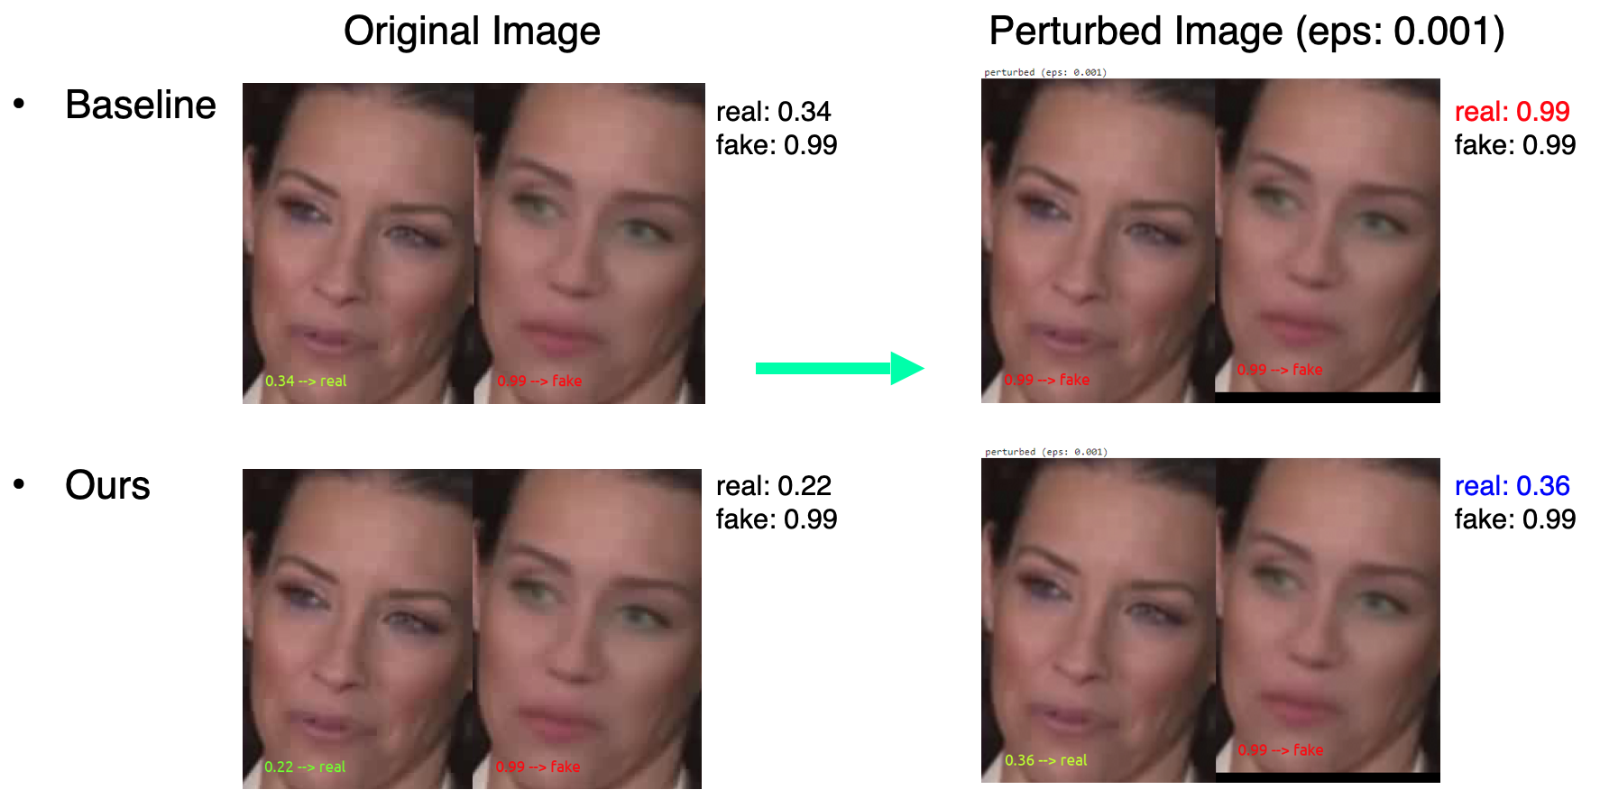
- Baseline 모델은 adversarial attack이 적용된 real 이미지를 fake로 잘못 판별하는 반면에 제안한 모델은 올바르게 판별
③ Physical condition shift 성능 향상 확인
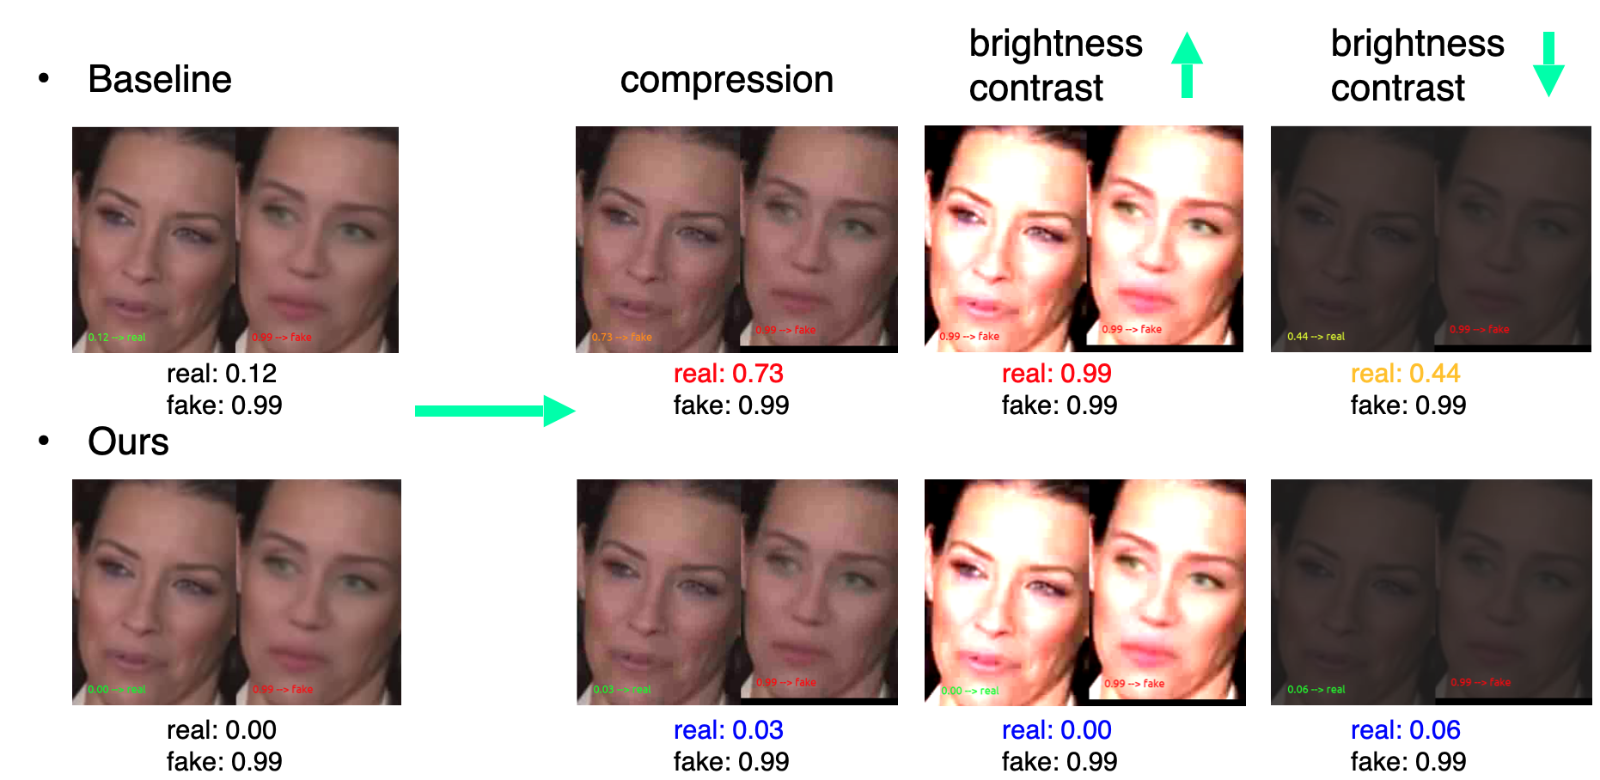
- 물리적 환경 변화가 발생했을때 baseline 모델은 환경에 민감하여 real 이미지를 fake로 잘못 판별하는 경향을 보인 반면, 제안 통합 모델은 모두 올바르게 판별하는 것을 정성적으로 확인
(3) 모델 추론 속도 비교
- CPU: Intel(R) Xeon(R) CPU E5-2686 v4 @ 2.30GHz
- GPU: Tesla V100-SXM2-16GB
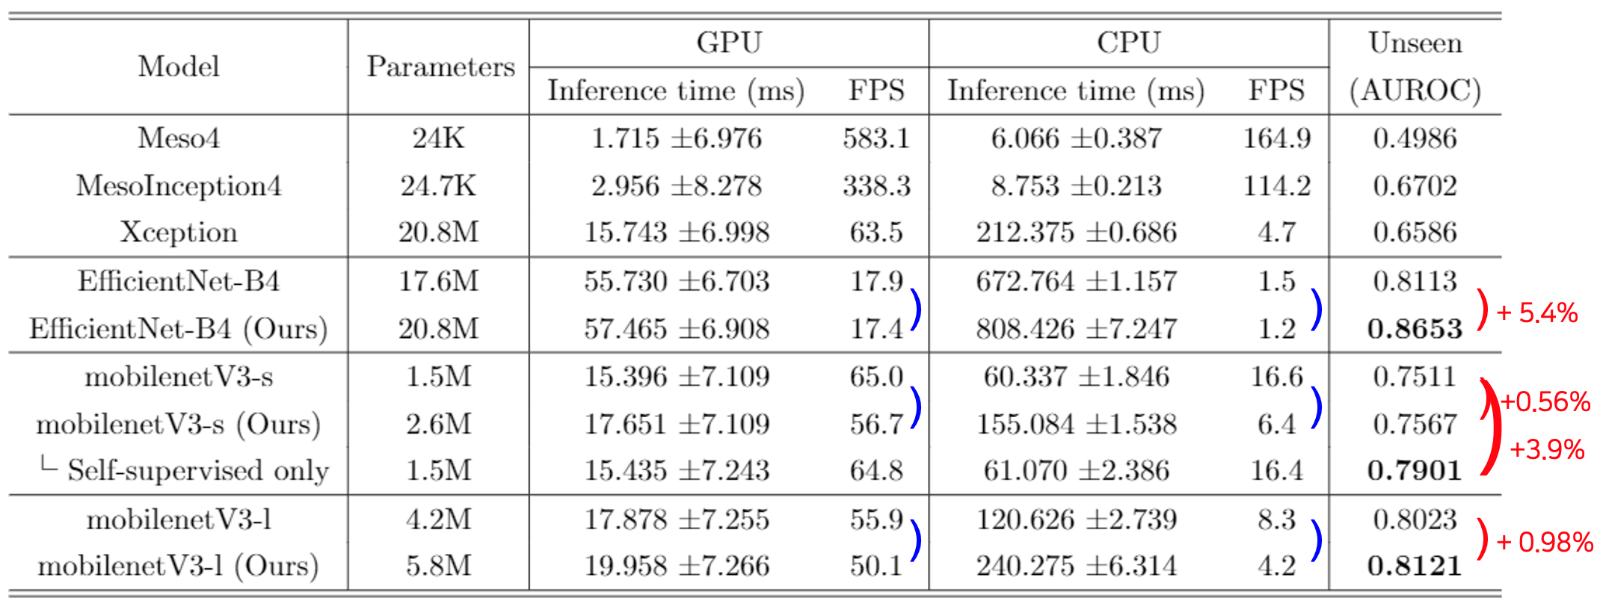
- 베이스라인 모델에 통합 모델 적용시 파라미터 수가 일부 증가하여 FPS 성능이 소폭 감소할 수는 있지만, 판별 성능과의 trade-off를 고려했을때 충분히 감내할만한 수준임을 확인 (200ms 이내)
4. 최종 통합 모델 Demo 영상
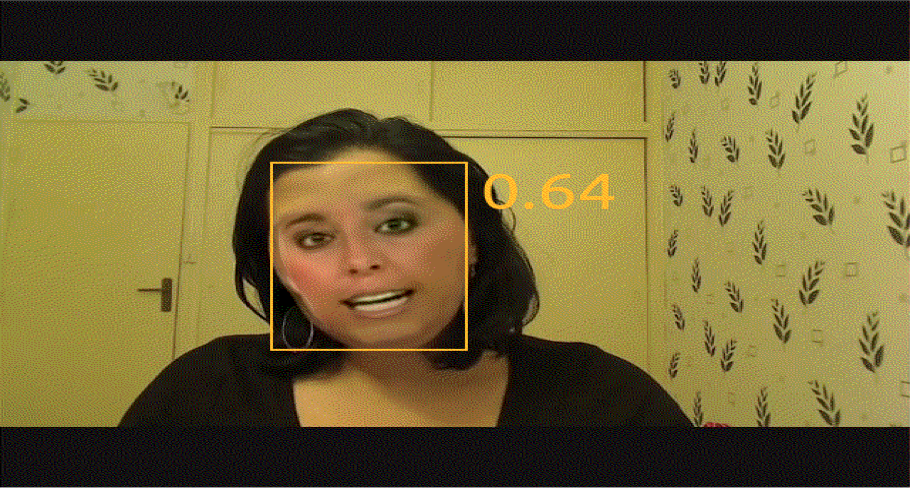
(unseen method (FaceForensics++) fake 영상, 왼쪽: baseline 모델, 오른쪽: 통합 모델)
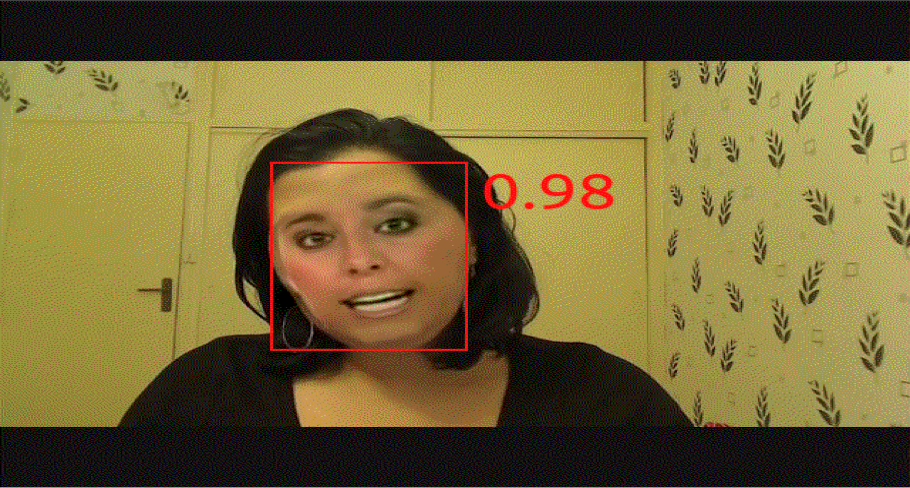

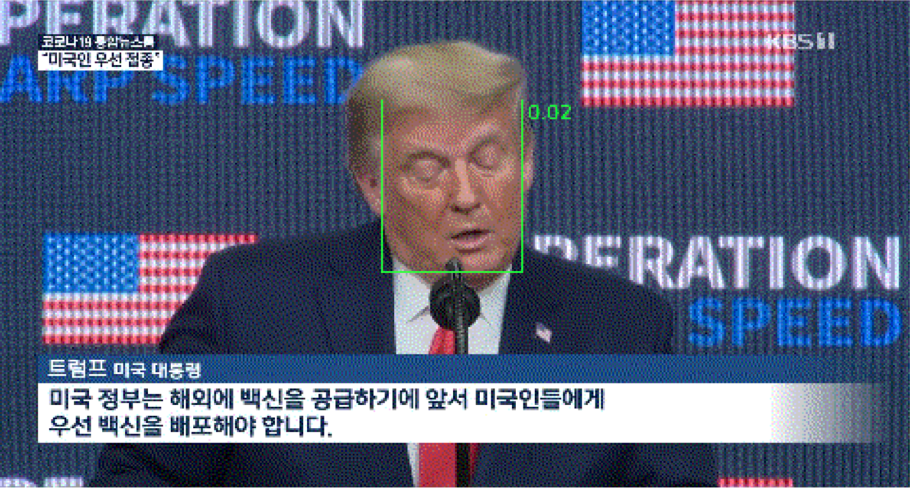
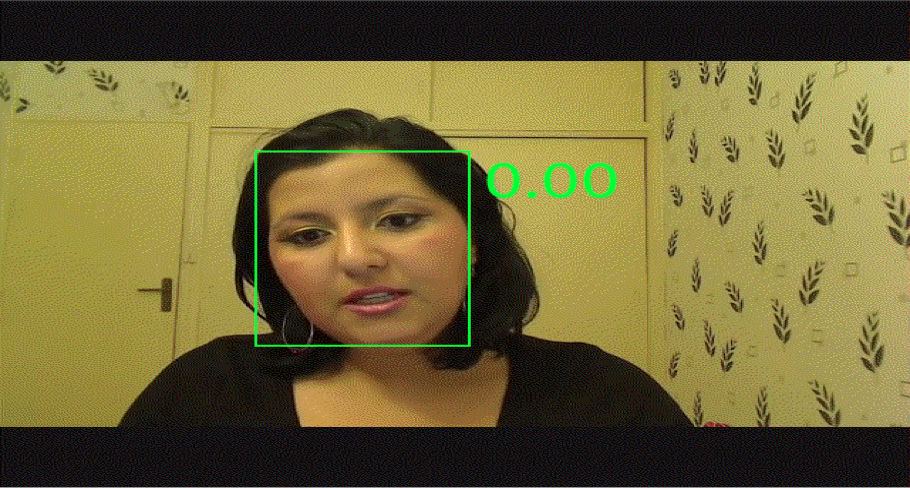
(unknown method (Youtube 영상) fake 영상, 왼쪽: baseline 모델, 오른쪽: 통합 모델)
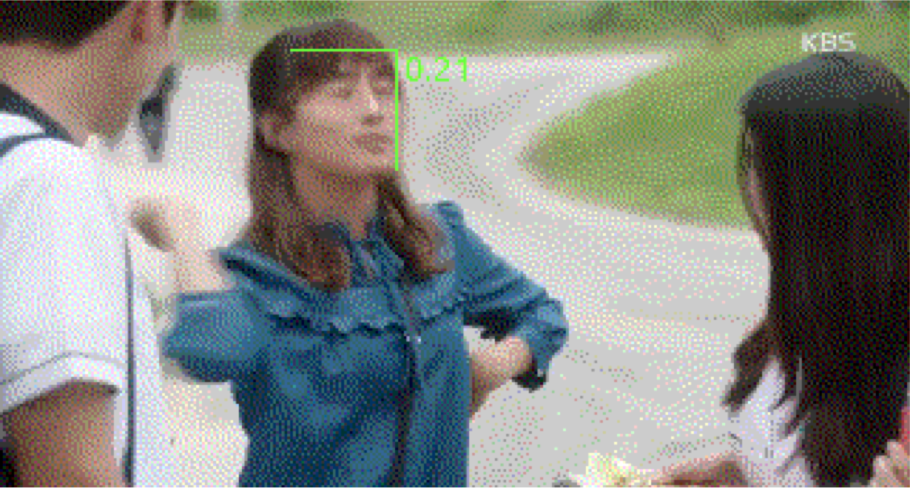
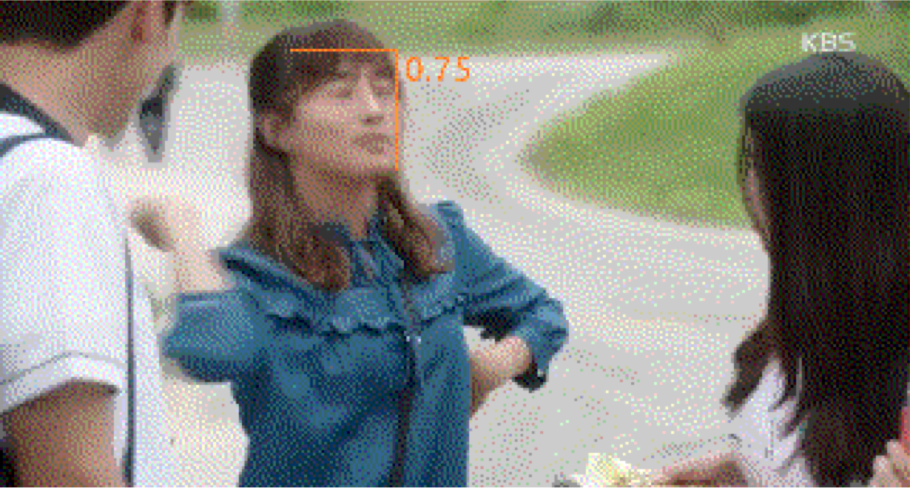

비디오 판별 시에는 여러 프레임을 판별하여 평균값이나 voting을 통해 최종 판별을 수행하는데 많은 프레임을 올바르게 판별할 수록 안정적인 판별을 수행하는데 유리하다고 할 수 있습니다.
baseline모델보다 저희의 모델이 보다 안정적으로 딥페이크 영상을 판별하는 것을 알 수 있습니다.
또한 저희의 통합모델이 fake영상 뿐만아니라 real 영상에 대해서도 올바르게 판단하는 것을 확인할 수 있었습니다.

5. 연구 결론 및 소감
저희가 이번 프로젝트를 진행하면서 얻을 수 있었던 연구 성과를 요약하면 다음과 같습니다.
- 딥페이크 판별 시 문제가 되는 Unseen method, adversarial attack, physical condition shift 3가지 어려운 각 환경을 대비하기 위해 SOTA 논문을 활용하여 개별 모듈을 개발하여 학습하지 않은 상황에 대해 유의미한 성능 향상을 이뤄낼 수 있었습니다.
- 각 모듈을 통합하여 3가지 환경에 대해 기존 모델보다 강인한 성능을 가진 통합 모델을 개발할 수 있었습니다.
(EfficientNet-B4: 강인한 성능의 서버용, MobileNetV3-small: edge device 판별용)
- baseline 모델에 비해 unseen method 환경에서 AUROC가 최대 5.4% 향상, Adversarial attack 환경에서 Accuracy가 최대 15% 이상 향상, Physical condition shift 환경에서 AUROC가 최대 4.5% 향상 시켰습니다.
향후 B2C 서비스등 현업에 활용할 것을 고려해 저희는 모델의 크기와 추론 속도를 고려해 서버용 모델과 edge device용 모델을 개발했고 추후 대용량의 Public DB와 서비스에 특성화된 Private DB를 사용해 더 우수한 성능의 모델로 서비스할 수 있을 것으로 기대됩니다.
이번 SKT AI Fellowship을 진행하면서 저희가 계획했던 목표가 쉽지 않았던 만큼 세명의 팀원들이 각 파트를 맡아 주도적으로 연구하고 협업하면서 많은 성장을 이룰 수 있었고, 또 5개월 간 저희의 프로젝트 진행과정을 지켜보며 조언과 피드백을 아낌없이 주셨던 멘토님 덕분에 효율적으로 저희의 모델을 완성하고 저희의 역량을 향상시킬 수 있었습니다!
연구실에서 한정된 관점에서 연구했던 것과 달리 현업 관점에서 고민하고 생각하면서 연구의 관점을 넓힐 수 있었고 일련의 연구 과정을 경험하며 연구자로서의 한차례 성장할 수 있었습니다. 이러한 기회를 만들어주신 SKT AI Fellowship 관계자 분들께 감사합니다 🙌
모두 고생하셨습니다 👏
팀딥텍터 님의 최신 블로그
더보기-

- GAN으로 생성된 거짓 영상 판별 기술 개발 - 연구결과(3)
- 안녕하세요, Team 딥텍터 (Deeptector) 입니다. 저희는 지난 5달동안 "🦄 GAN으로 생성된 거짓 영상 판별 기술 개발" 라는 연구 과제로 SKT AI Fellowship 3기로 참여했었는데요. 11월 15일 최종 발표를 끝으로 드디어 막을 내렸습니다. Unseen 환경을 다루는 주제였던만큼 쉽지는 않았지만 다양한 측면에서 고민하며 많은 점을 배울 수 있었습니다. 오늘 마지막 장에서 저희 팀의 최종 결과물을 공유드리겠습니다! 이전 글은 아래에서 참고해주세요! 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163229 연구과정(2) 블로그 참조 : https://devoce...
-

- GAN으로 생성된 거짓 영상 판별 기술 개발 - 연구과정(2)
- 안녕하세요, 저희는 이번 SKT AI Fellowship 3기에서 "🦄 GAN으로 생성된 거짓 영상 판별 기술 개발" 연구 과제를 수행중인 Team 딥텍터 (Deeptector) 입니다. 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163229 이번 장에서 저희가 해결할 문제에 대해 다시 한번 짚어보고, 어떻게 해결해 나아가고 있는 지 중간 과정을 소개드리겠습니다 :) 1) 연구 과제 소개 및 목표 Remind (1) 연구 과제의 배경 'GAN으로 생성된 거짓 영상'은 딥페이크라고도 알려져 있는데요 저희의 연구 주제인 딥페이크는 딥러닝 기반의 얼굴 조작 기술이나 그 기술로 생성된 미...
-

- GAN으로 생성된 거짓 영상 판별 기술 개발 - 연구계획(1)
- 안녕하세요, 저희는 이번 SKT AI Fellowship 3기에서 "🦄 GAN으로 생성된 거짓 영상 판별 기술 개발" 연구 과제를 수행중인 Team 딥텍터 (Deeptector) 입니다. 앞으로 저희가 진행할 과제가 어떤 문제를 해결하고자 하는지, 이를 어떻게 해결해 나아갈 지 이번 장에서 소개드리겠습니다! - 댓글과 메일을 통한 연구 소통은 매우 환영입니다! 1) 연구 과제 소개 (1) 연구 배경 'GAN으로 생성된 거짓 영상'은 최근 언론을 통해 '딥페이크'라는 이름으로 더욱 많이 알려져 있는데요. 다양한 편집 어플리케이션에서도 쉽게 사용되면서 우리의 일상 생활에서도 점차 존재감을 드러내고 있습니다. 딥페이크가 뭔가요? '딥페이크 (Deepfake)'는 De...
DEVOTEE 추천 블로그
-

- 서비스 로봇용 신규 Vision AI 응용 기술 개발 - 연구 결과(3)
- 안녕하세요 SKT AI Fellowship 3기 1번 과제 서비스 로봇용 신규 Vision AI 응용 기술 개발을 연구하고 있는 신서유기입니다. 어느덧 연구를 시작한지 5개월이 지났고, 연구 내용들에 대해 전달해드리려고 합니다. 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163228 연구계획(2) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163336 먼저 저희는 저희가 개발한 로봇 AI 비전 애플리케이션 과제에 제목과 맞게, 로봇에 탑재되는 PC에 딥러닝 기반의 여러 기능등을 탑재하여 Coex에서 열린 SKT 부스...
-
- Deep Learning 기반 Depth Estimation with Mono Camera - 연구 결과 (3)
- 안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행했던 IDE 팀입니다. 벌써 6개월이 지나 마무리를 하게 되었네요 비전공자로써 다양한 연구들을 보며 시야를 넓히고 저희의 역량을 기를 수 있었던 소중한 시간이었습니다:) 연구 결과에 대한 이야기로 마지막 포스트를 올리며 마무리 하고자 합니다 기존 모노뎁스 모델의 방법과 문제점 지난 포스트에서도 말씀드렸듯이 기존 모노 뎁스 모델의 경우, 크게 (1) 딥러닝 방식 / (2) 삼각측량법을 적용한 방식으로 나눌 수 있습니다. 각각의 방식에 대한 문제점은 다음과 같습니다. (1) 딥러닝방식 -단일 ...
-
- 생성형 AI 기술을 이용한 보이스 피싱 탐지 기술 개발 - 연구 결과(3)
- 안녕하세요! SKT Fellowsup 6기 생성형 AI 기술을 이용한 보이스 피싱 탐지 기술 개발 과제를 진행한 피싱피싱(Phishing Fishing) 입니다. 이번 포스트에서는 최종 연구 결과를 공유하며, 저희가 문제를 어떻게 정의했는지, 어떤 접근 방식을 취했는지, 그리고 어떤 결과를 도출했는지를 차례대로 소개해 드리겠습니다. 연구 과제 소개 요즘 뉴스에서 자주 등장하는 "딥페이크"와 "보이스피싱" 이제는 단순한 화제가 아닌, 실질적인 사회적 위협으로 자리 잡고 있습니다. 특히 이 기술을 악용한 보이스피싱은 더 정교한 수법과 기술로 사람들에게 실제 피해를 주고 있습니다. 저희는 이에 효과적으로 대응할 수 있는 기술을 개발하는 것을 목표로 하고 있습니다. 영화...
-
- 스마트폰 센서 활용 PDR 모델 연구 - 연구 결과(3)
- 안녕하세요! SKT AI Fellowship 6기 슼폰지 팀입니다. 저희는 스마트폰 센서를 활용한 보행자 위치 추정(PDR: Pedestrian Dead Reckoning) AI 모델 개발을 주제로 약 5개월간 연구를 진행했습니다. 이전 포스팅에서 (1)연구 소개 (2)연구과정을 공유했는데요, 마지막 포스팅인 만큼 이번에는 저희 연구를 간략하게 다시 소개드리고, 최종 수행 과정과 결과를 공유하겠습니다. 연구 소개 현대 사회에서 위치 기반 애플리케이션은 우리의 일상생활에 깊숙히 자리 잡고 있습니다. 길찾기 앱부터 자전거 공유 서비스, 운동 기록 앱, 그리고 위치 기반 게임까지 GPS를 활용한 실시간 위치 추적 기술은 다양한 분야에서 사용되고 있습니다. 이러한 기술은...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.