
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Multi-modal 감정 인식 AI 모델 개발 - 연구계획(1)

안녕하세요.😄
저희는 멀티모달 감정 인식 AI 모델 개발 연구를 진행하게 된 SKT AI fellowship 3기Cycling Hit 팀입니다! 이 포스팅을 통해 SKT AI Fellowship에서 저희가 앞으로 진행하게 될 내용에 대해 전해드리려고 해요.
Emotion Recognition이란?
'감정 인식'이라는 분야를 떠올리면, 다들 아직 생소한 느낌을 받으실 것 같은데요, 하지만 저희의 일상 모든 부분에 감정이 녹아있음을 생각하면 그 활용 범위가 무궁무진함을 알 수 있습니다. SKT AI Fellowship의 여러 주제들 중에서도, 저희는 사람의 감정을 인식하는 방법에 흥미를 느껴서 해당 주제를 선택하게 되었습니다. 사용자의 표정, 억양, 행동 등 각종 데이터를 분석하여 감정적인 맥락을 추가하면 Human Computer Interaction(HCI)에 주요한 역할을 할 수 있습니다. 실제로, Amazon에서는 기쁘거나 화난, 또는 슬픈 어조로 응답이 가능한 Alexa를 출시하고 있습니다.
사람의 표정, 말투, 대화, 행동 등 거의 모든 표현에 그 감정이 녹아 있을텐데, 저희는 이러한 다양한 정보 중에서도 '말'에 집중하여 음성🗣️과, 그 텍스트💬를 통해 Multi-modal Emotion Recognition을 연구해보고자 합니다.
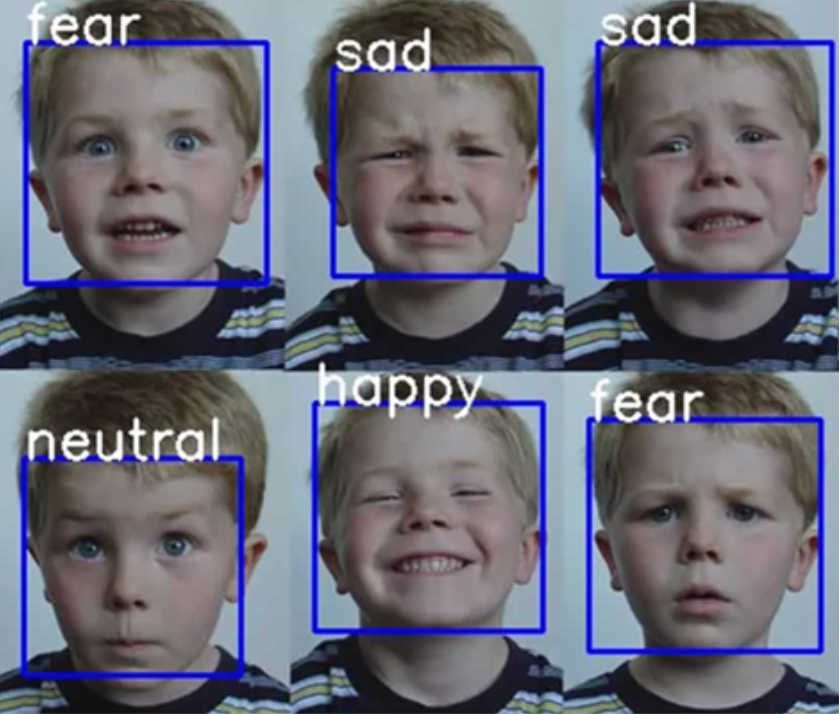
사실 음성과 텍스트, 또는 이미지나 영상, 센서 정보 등을 각각 활용한 감정 인식 연구는 활발하게 이루어지고 있지만, 저희의 주제처럼 음성과 텍스트 정보를 모두 활용한 Multi-modal Emotion Recognition에 대한 선행 연구는 아직 많지 않은 상황입니다. 특히나 한국어 데이터셋에 대해서는 기존 연구 발표 내용이 극히 제한적이라는 부분에 기인하여, 저희는 한국어 감정 인식에 대해 새로운 지표를 열어보고자 합니다. ㅎㅎ
연구 목적 및 목표
저희의 연구 목적은 다음과 같습니다.
- Speech&Text활용 가능한 Emotion Recognition Datasets 확보(한글/영어)
- 음성(Speech), 텍스트(Text) Encoder로부터 감정 인식에 효과적인 Modality Fusion 방식 고안
- Multi-modal Emotion Recognition 모델 설계 및 정확도 성능 고도화
먼저, Emotion Recognition만을 위해 따로 사용되는 충분한 양의 데이터셋이 많지 않기 때문에, 텍스트와 음성 정보가 모두 담겨 있으면서도 감정 Labeling이 되어 있는 데이터셋을 모아 구축해야 합니다. 이후 Speech와 Text Encoder로부터 효과적인 감정 분류가 가능한 Fusion 방식에 대해 여러 실험을 통해 연구할 계획입니다. 한국어 데이터셋에 대해 효과적인 모델을 개발한 후에는, 영문 데이터셋에도 적용하여 세계적인 감정 인식 성능을 위해 도전할 것입니다! 🛩️
연구 배경 소개
세부적인 연구 진행 내용을 첫 포스팅에서 다루기는 힘들겠지만, 저희의 연구 배경에 대해서 간략하게나마 소개해볼까 합니다.
Uni-modal Emotion Recognition
보통 사람의 감정이 가장 잘 나타나면서도, 해당 데이터를 수집하기 좋은 것은 아마 표정, 목소리, 대사 등이 있을 것입니다. 이 외에도, 심박수나 심전도 등 바이오 정보를 통해서도 사람의 감정에 대해 분류하고자 하는 선행 연구들이 있었습니다. 그 중에서도 저희 연구와 직접적으로 연결된 음성, 텍스트에 대해서 각각의 정보만 활용하는 방법에는 다음과 같은 것들이 있습니다.
Speech 🗣️
음성에서는 주로 Prosodic Feature와 Spectral Feature의 두 가지 특징을 사용합니다. 주파수 대역으로 변환하여 활용할 수 있는 Spectral Feature 중에서도, 가장 흔하게 사용되는 것은 MFCC 또는 Logmel과 같은 특징들이 있습니다. 이들은 사람의 음성이 낮은 주파수 쪽에서 더 많은 정보를 가지고 있다는 점에서 착안하여 Spectral Scale을 조정한 Feature입니다. 저희 팀원이 녹음한 ' 오늘 좋은 일이 있었어 ' 에 대한 음성 파일을 Waveform과 Spectrogram, 그리고 Logmel Spectrogram으로 나타내보면 순서대로 다음 그림과 같이 나타납니다.
Script: "오늘 좋은 일이 있었어."
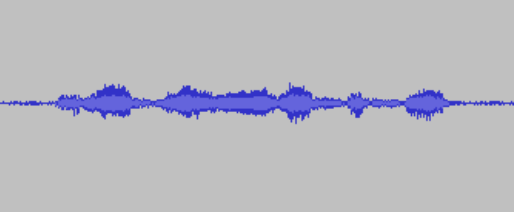
파형 (waveform)
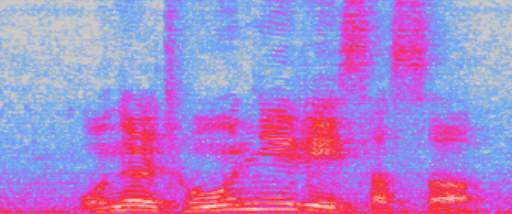
Spectrogram
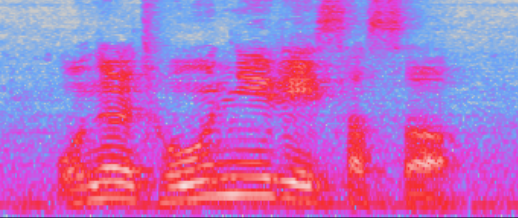
Log Mel Spectrogram
파형으로 보는 오디오 정보와 스펙트로그램으로 보는 오디오 정보 사이의 굉장한 차이가 느껴지시나요? Spectrogram는 Time Waveform의 Discrete Sampled Data를 Fourier Transform하여 계산이 되어집니다. x축과 y축은 각각 시간과 주파수를 나타내는데, 그림을 확인해보면 사람의 목소리 정보가 낮은 주파수 부분에 깔려 있다는 점이 보이실 겁니다. 사람은 주파수를 Linear Scale로 인식하지 않기 때문에 주파수를 Mel Scale로 전환시켜서 많이 사용합니다. 또한, 사람은 높은 수준의 파워보다 낮은 파워의 강도 차이를 더 쉽게 알아차리기 때문에 Logmel Spectrogram를 계산하여 활용합니다. 이외에도, 음성인식에서 주로 사용되는 Mel-Frequency Cepstral Coefficient (MFCC)를 생각해볼 수 있습니다.
모델 구조로는 현재까지 시계열 데이터를 처리하는 데 가장 뛰어난 성능을 보이고 있는 Attention Mechanism이 주로 사용됩니다.
Text 💬
텍스트와 감정 사이의 연결을 짓는 모델을 가장 간단하게 생각해보면 키워드를 통한 감정 인식 방법이 있습니다. 각각의 키워드에 대해 감정 레이블이 제공된다면, 쉽게 분류하는 모델을 만들 수 있지요. 하지만 문장 안에 labeled 감정 키워드가 존재하지 않는다면, 감정을 분류할 수 없다는 문제점이 있습니다. 온 세상의 모든 단어에 감정 레이블링을 진행할 수는 없는 노릇이기에, 효과적으로 사용하기에는 무리가 있는 모델링입니다.
이를 보완하기 위해서 Rule-Based Approach로 문장에 Preprocessing 과정을 거친 후 Computation, Linguistics, Statistics 등의 개념을 사용한 Emotion Rules를 만들어 분류하는 방법 등이 고안되었습니다. 이후 머신러닝, 딥러닝이 활발히 연구되면서 자연어처리 기법 또한 감정 인식에 적용할 수 있게 되었습니다. 특히나, SKT에서 발표한 KoBERT나 KoGPT등과 같은 모델도 저희가 감정 인식 모델에 유용하게 활용해볼 수 있기를 기대하고 있습니다. 😆
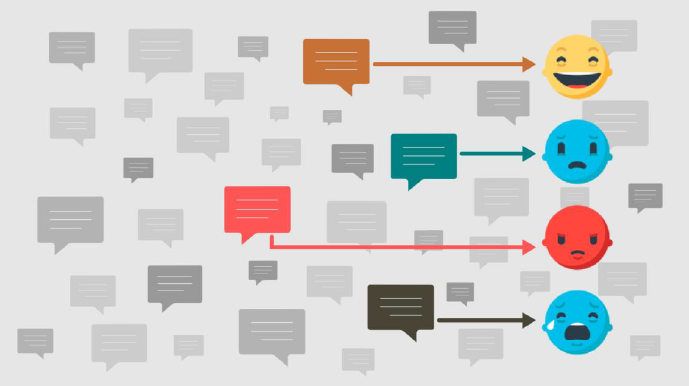
Multi-modal Emotion Recognition
위에서 소개한 Speech/Text Feature를 모두 활용하여, 감정 인식에 가장 효과적인 Fusion 방식을 찾는 것이 저희의 목표입니다! 어떤 방식으로 결합해야 각각의 feature를 한 종류만 사용할 때보다 더 좋은 성능을 보일 수 있을지가 관건이 될 것으로 예상합니다. 물론 최근 AI분야에서 활발하게 연구되고 있는 Speech/Text Representation 학습에 대해서도, 어떤 Feature를 적용하느냐에 따라 모델의 성능에 큰 영향을 미칠 것입니다. 그러니까 저희의 연구 방향을 한 마디로 정리해 보자면, "Speech와 Text의 어떤 Feature를 어떻게 잘 섞어서 높은 감정 인식 정확도를 보이는 모델을 만들 수 있을까?!"가 되겠네요. 최대한 다양한 실험과 도전으로 높은 성능을 보이기까지 모두 노력하도록 하겠습니다. ㅎㅎ
Cycling Hit팀 소개
마지막으로 저희 팀에 대해 소개하며 마치겠습니다. Cycling Hit란 야구에서 한 타자가 한 경기에서 1루타, 2루타, 3루타, 그리고 홈런까지 가능한 모든 안타를 치는 것을 뜻합니다. 저희도 SKT AI Fellowship이라는 그라운드 위에서 가능한 모든 안타를 치겠다는 의미로 팀 이름을 짓게 되었습니다. 저희는 서강대학교 전자공학과 지능정보처리연구실에서 음성 향상/인식, 립리딩, 영상 인식, 음향 인지, 음원 위치 추정 등의 연구를 진행하고 있습니다. SKT의 김창현 멘토님과 함께 사이클링 히트를 칠 수 있도록 열심히 연구하겠습니다! 😼
9a3710 님의 최신 블로그
더보기

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.