
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
우리 아이가 달라졌어요: 텍스트에 워터마크를 어떻게 넣을까

- DEVOTEE 요약
- LLM 서비스에 텍스트 워터마크가 도입된 이후, 단어 선택이 어색해져 PM들이 다른 모델로 이탈하는 현상이 발생했습니다. 텍스트 워터마크는 AI 생성 글임을 판별하기 위해 문맥과 비밀키를 활용해 특정 토큰의 선택 확률이나 순위 패턴을 조작하는 기술입니다. 대표적으로 KGW, SynthID-Text, textGrain 등의 방식이 있으며, 모두 평균적인 확률 분포를 유지하려 노력하지만 고정된 키 환경에서는 단어 선택의 자연스러움이 저하될 수 있습니다.
우리 아이가 달라졌어요: PRD 에이전트가 이상한말을 해요.
뤼튼에서 인턴으로 일하던 올해 여름, 같은 IAB중 PM들이 사용할 PRD Generator Agent를 만드는 동료 인턴이 있었다.
8월쯤 PM분들이 에이전트 성능이 이상하다는 이야기를 들었다. 심지어 클로드가 이상한말을 해서 직접 타자를 쳐서 PRD를 작성까지한다고 들었다..!(AI없이, 26년 8월에..?)
Claude Fable API 출력에 텍스트 워터마크가 들어가기 시작한 뒤 단어 선택이 눈에 띄게 어색해졌고, PM들이 결국 Agent에서 Fable 대신 gemini나, GPT계열 모델들을 쓰게 됐다는 내용이었다.
아니 근데 어떻게 text에 워터마크를 넣나? 궁금했다. 이미지는 픽셀값을 미세하게 변형하거나 메타데이터에 워터마크를 박는게 쉬울텐데..
먼저 PM들이 작성하는 PRD는 누가 읽어도 요구사항을 같은 뜻으로 이해해야 하는 문서다. 문장은 얼핏 그럴듯한데 단어가 어색하면, 읽는 사람이 의도를 다시 해석해야 한다.
문서 작성을 도와주는 Agent가 오히려 문장을 고치는 일을 늘린다면 사용하는 입장에서는 모델을 바꿀 이유가 충분하다.
시점과 읽을 자료부터 정리
Anthropic이 제시한 신규 모델의 적용 기준은 2026년 8월 2일이고, 워터마크의 원리를 설명한 공식 글은 8월 14일에 공개됐다.
단어 선택과 품질을 둘러싼 논쟁은 8월 기사에서도 다뤄졌다.
이 보도는 당시 어떤 문제의식이 있었는지 이해하는 데 참고했고, 구현 원리는 공식 자료와 논문에서 확인했다.
최근 내가 자주보는 유튜버인 임커밋님의 「텍스트 워터마크..? 어떻게?」도 참고했다.
2026년 9월 10일 공개된 영상으로, 생성 후보에 점수를 매기는 과정과 그 점수로 워터마크를 검출하는 과정을 연결해 설명한다.
처음 동료가 알려준 텍스트에 워터마크 넣는 방식은 Red-Green논문을 읽어보라고 해서 그 논문부터 시작했다.
특정단어의 확률을 높이는걸로, 워터마크를 넣는다면, 일단 결정론적이지가 않고 확률로만 그게 AI작성글인지 아닌지를 알 수 있을테다.
그리고 토큰수가 많아질수록(표본이 커질수록) 신뢰도가 높아질거다.
“바나나, 원숭이” 라는 문장을 가지고는 당연히 ai작성인지 아닌지 판단을 못할테다.
세 방식은 문맥에서 재현할 수 있는 난수를 토큰 선택에 연결한다는 공통점이 있다.
다만 SynthID-Text와 textGrain이 KGW의 Green 토큰 보너스를 그대로 사용하는 것은 아니다.
Claude는 SynthID-Text의 변형을 사용한다고 설명하고, OpenAI는 textGrain을 공개했다.
먼저 LLM이 다음 토큰을 고르는 방식
LLM은 문장을 한 번에 완성하지 않는다.
Attention 아키텍처, Transformer논문에서 익히 공부했던것처럼, 지금까지의 문맥을 보고 다음 토큰의 확률을 계산한 뒤, 그 분포에서 하나를 고른다.
토큰은 단어 전체일 수도 있고 단어의 일부일 수도 있다. 아래 예제에서는 설명을 쉽게 하려고 단어 하나를 토큰 하나처럼 다뤘다.
pt(v)=softmax(zt/T)v,xt∼pt(⋅∣x<t)
z는 모델의 logit, T는 temperature다. pₜ는 시점 t에서의 다음 토큰 분포이고, xₜ는 그 분포에서 뽑은 토큰이다. 실제 생성에는 top-p 같은 설정도 들어갈 수 있다.
핵심은 보통의 샘플링이 항상 확률 1위 토큰만 고르는 방식은 아니라는 점이다.
예를 들어 ‘변경 이력은 _’ 다음에 ‘보관한다’가 0.60, ‘저장한다’가 0.30, ‘기록한다’가 0.10이라고 해보자. 워터마크가 없어도 0.30짜리 후보가 나올 수 있다.
그러므로 ‘최고 확률의 단어가 선택되지 않았다’는 사실만으로 품질 저하나 워터마크를 판정할 수는 없다.
텍스트 워터마크는 이 선택 과정에 비밀키와 연결된 통계적 패턴을 남긴다. 검출기는 나중에 결과 텍스트를 읽으며 같은 키로 패턴을 재구성한다.
글 뒤에 표시 문장을 붙이거나 보이지 않는 공백을 넣는 방식과는 작동 위치가 다르다.
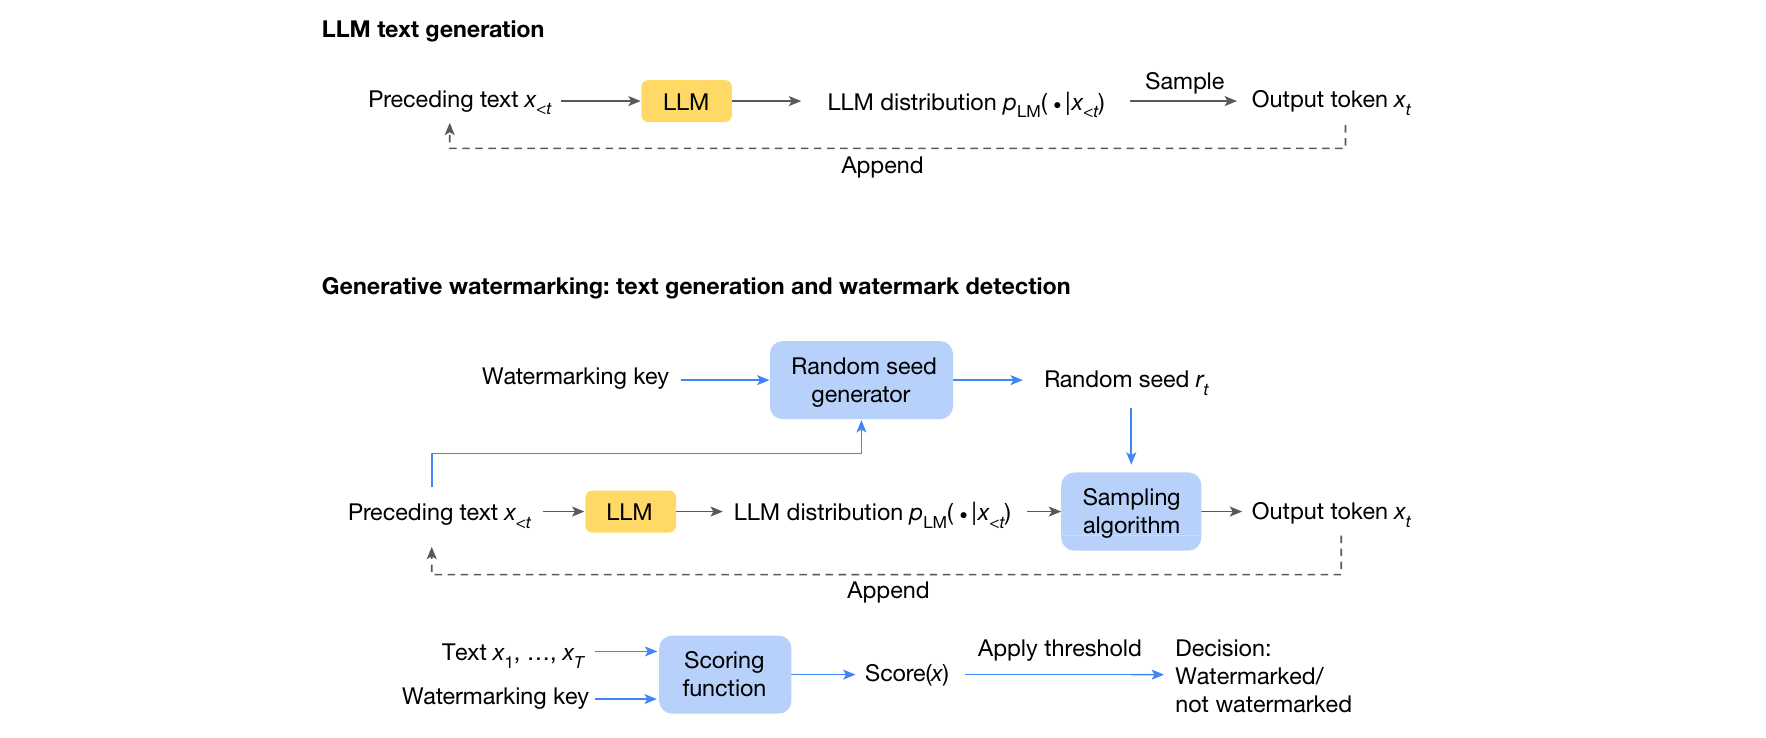
그림 1. SynthID-Text 논문의 Fig. 1을 캡처했다. 생성할 때 샘플링에 키가 개입하고, 검출할 때 텍스트와 키를 사용한다. 출처: Dathathri et al., 2024.
KGW: Green–Red List로 기본 원리 이해하기
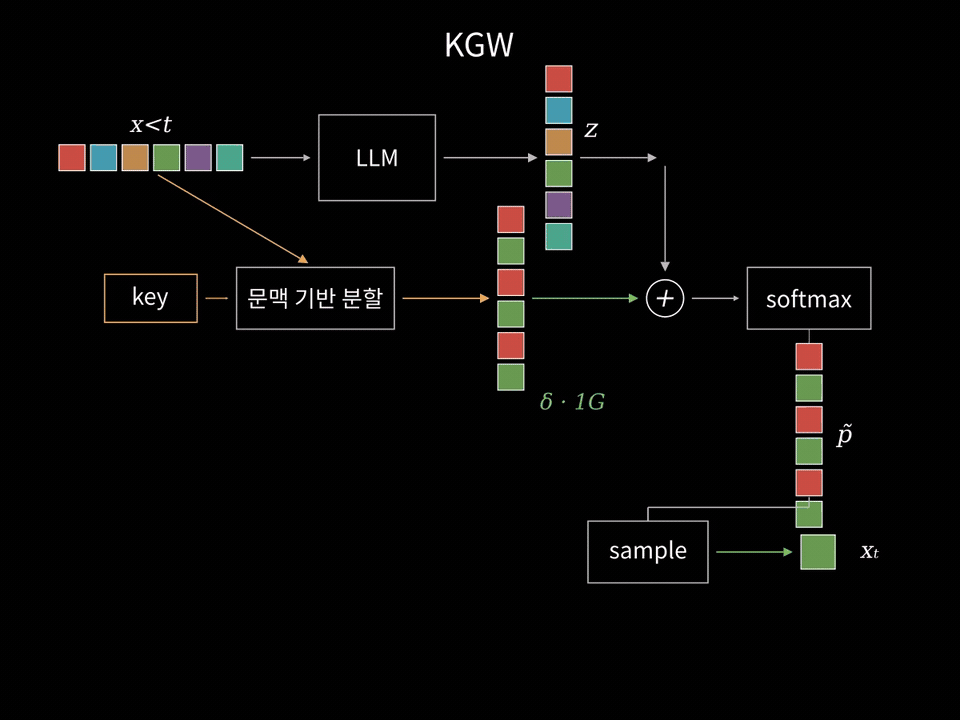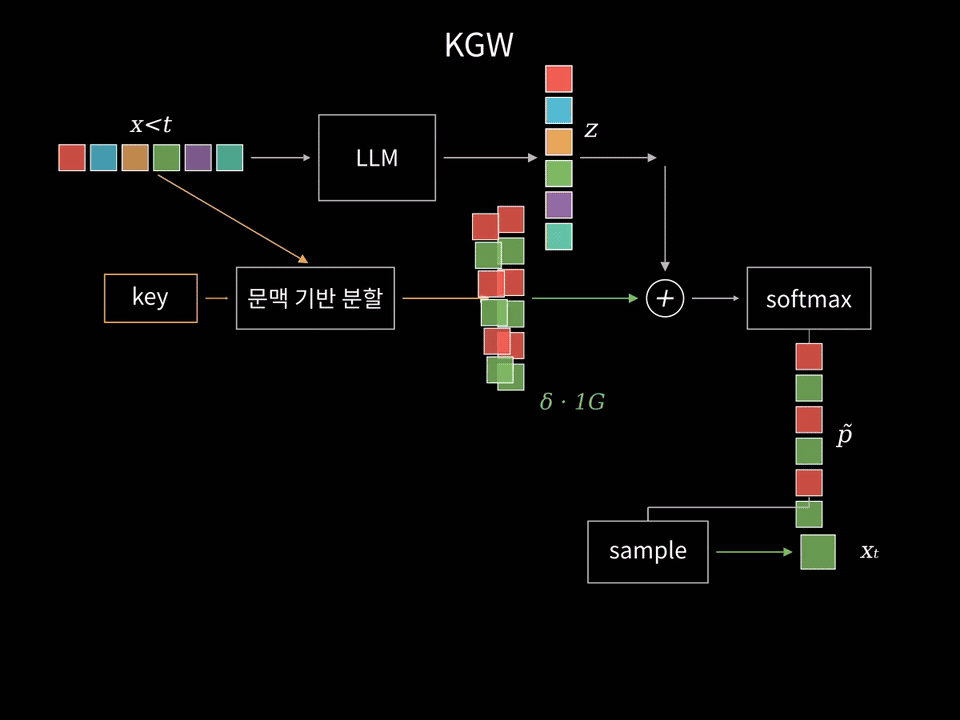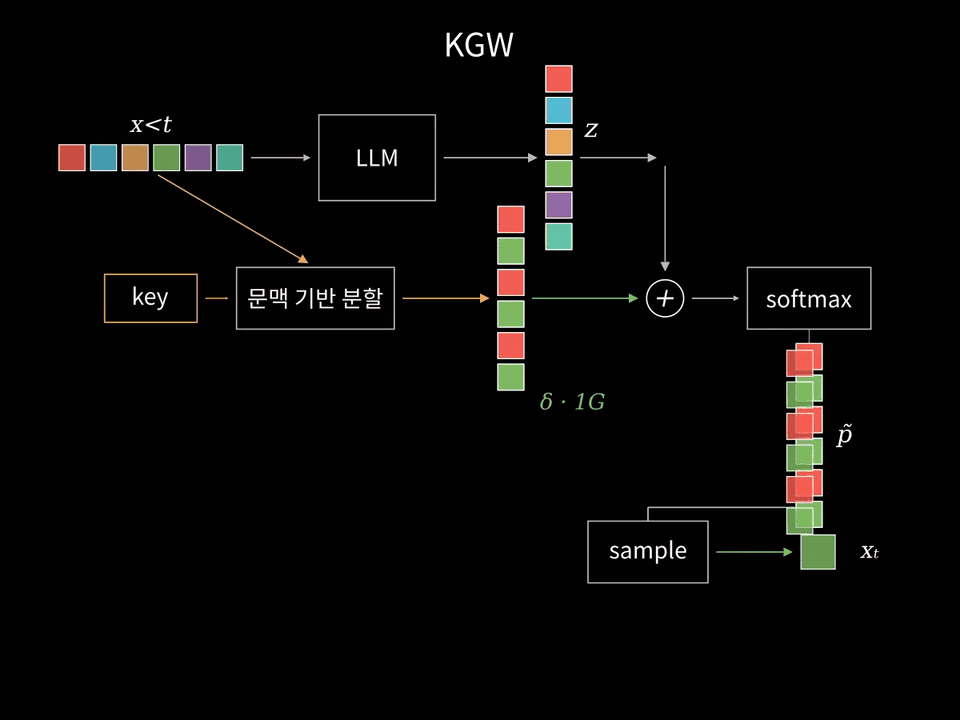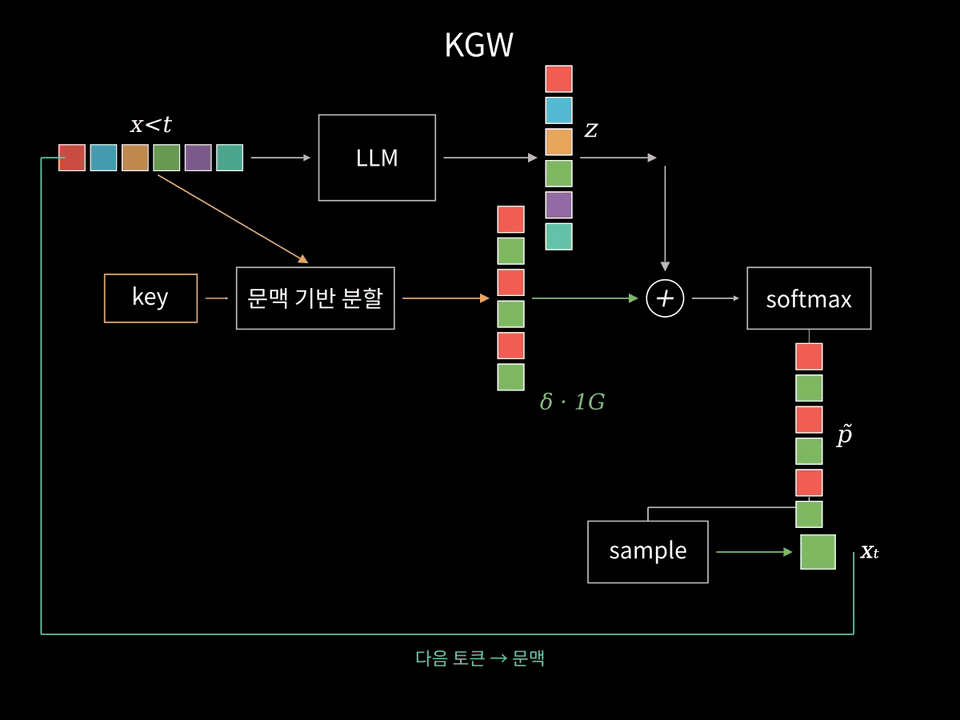
문맥과 키로 어휘를 Green/Red 집합으로 나눈다.
Green 마스크에 따른 δ 편향을 모델의 logits에 더하고, softmax와 샘플링을 거쳐 다음 토큰을 고른다.
선택한 토큰은 다음 생성 단계의 문맥으로 돌아간다.
KGW는「A Watermark for Large Language Models」에서 제안한 방식이다.
다음 토큰을 고를 때 어휘 집합 V를 Green List Gₜ와 나머지 Red List Rₜ로 나눈다.
앞선 토큰 문맥으로 의사난수 생성기의 시드를 정하기 때문에, 검출기도 같은 설정으로 그 시점의 분할을 재현할 수 있다.
시드 구성이나 문맥 길이는 구현에 따라 달라질 수 있다.
Green은 좋은 단어, Red는 나쁜 단어라는 뜻이 아니다. 같은 토큰도 문맥이 바뀌면 다른 집합에 들어갈 수 있다.
핵심은 생성기가 알고 검출기가 다시 만들 수 있는 임의의 구분이다.
일반적으로 설명하는 soft KGW는 Green 토큰의 logit에 δ를 더한 뒤 샘플링한다. Red 토큰의 확률을 0으로 만드는 것은 아니다.
논문의 hard 방식과 구분해서 읽어야 한다. 아래 식은 temperature 등을 적용한 생성용 logit을 z로 표기한 soft 방식이다.
p~t(v)=exp(zt(v)+δ1{v∈Gt})∑u∈Vexp(zt(u)+δ1{u∈Gt})
Gₜ는 그 시점의 green list, δ는 보너스 크기다. 표시된 집합에 속하면 logit에 δ를 더하고 softmax를 다시 계산한다.
‘저장한다’에 보너스가 붙으면 원래보다 선택될 가능성이 높아질 수 있다.
δ를 크게 잡을수록 표시는 강해지지만 원래 분포와의 차이도 커진다.
Green 토큰이 우연보다 많이 나왔는지 검출한다
zdetect=C−γNNγ(1−γ)
검출기는 출력의 각 위치에서 Green List를 다시 만들고, 실제 토큰이 Green에 속한 횟수 C를 센다.
Green이 전체 어휘에서 차지하는 비율을 γ, 검사한 토큰 수를 N이라고 하면, 워터마크가 없는 텍스트의 기준 모형에서는 Green 횟수를 대략 γN으로 기대한다.
표준화 통계량은 z = (C − γN) / √(Nγ(1 − γ))다. 이 z는 위 식의 모델 logit과 다른 값이다.
예를 들어 γ = 0.5이고 N = 100이면 기준 기대 횟수는 50, 표준편차는 5다. Green 토큰이 70개 관측되면 z = 4가 된다.
특정 임계값을 통과했다고 작성자의 신원이나 사용 모델까지 확정되는 것은 아니다.(결정론적이 아니니깐!)
반복 문맥 때문에 관측이 독립적이지 않을 수 있어, 실제 검출에서는 반복 처리와 오검출률 보정이 필요하다.
확률을 밀어주는 것과 분포를 보존하는 것
앞의 PRD 예제에서 ‘저장한다’만 Green이고 δ = log 2라고 해보자.
원래 확률 0.60, 0.30, 0.10에 곱해지는 가중치는 1, 2, 1이다.
정규화하면 ‘보관한다’는 약 0.462, ‘저장한다’는 약 0.462, ‘기록한다’는 약 0.077이 된다.
Green 후보가 더 자주 나오도록 원래 분포가 바뀐 것이다.
좋은 후보가 여럿인 문맥에서는 선택 여지가 있지만, 특정 표현이 필요한 문맥에서는 다른 후보를 밀어주는 효과를 더 주의해서 봐야 한다.
KGW는 이런 분포 변화와 검출력을 함께 다룬다.
δ를 높이면 신호가 강해지는 대신 분포 변화도 커질 수 있다.
두 후속 논문에서 내가 더 보고 싶었던 것은 이 관계를 다루는 방법이었다.
SynthID-Text 논문은 KGW를 Soft Red List 비교 기준으로 사용하고, textGrain의 Appendix C도 Green List 방식과 자신의 접근을 구분한다.
Claude의 기반 방식: SynthID-Text
후보 토큰끼리 토너먼트를 시킨다
KGW에서는 Green 토큰에 보너스를 더하고 확률을 다시 계산했다.
SynthID-Text의 Tournament Sampling은 원래 LLM 분포에서 후보들을 뽑은 뒤, 문맥과 비밀키로 만든 의사난수 점수에 따라 두 후보씩 겨룬다.
동점은 무작위로 처리하고, 여러 층을 거쳐 남은 토큰을 출력한다. 높은 워터마크 점수는 좋은 문장이라는 뜻이 아니다. 키와 연결된 임의의 점수다.
점수에 0과 1을 사용하면 두 색으로 나누는 것처럼 보일 수 있다. 그래도 생성 절차는 다르다.
KGW의 soft 방식은 전체 어휘의 logit을 수정하고, 여기서는 원래 분포에서 나온 후보들의 대결이 선택 확률을 정한다.
논문은 이 토너먼트가 특정 조건에서 원래 분포를 보존하는 이유를 분석한다.
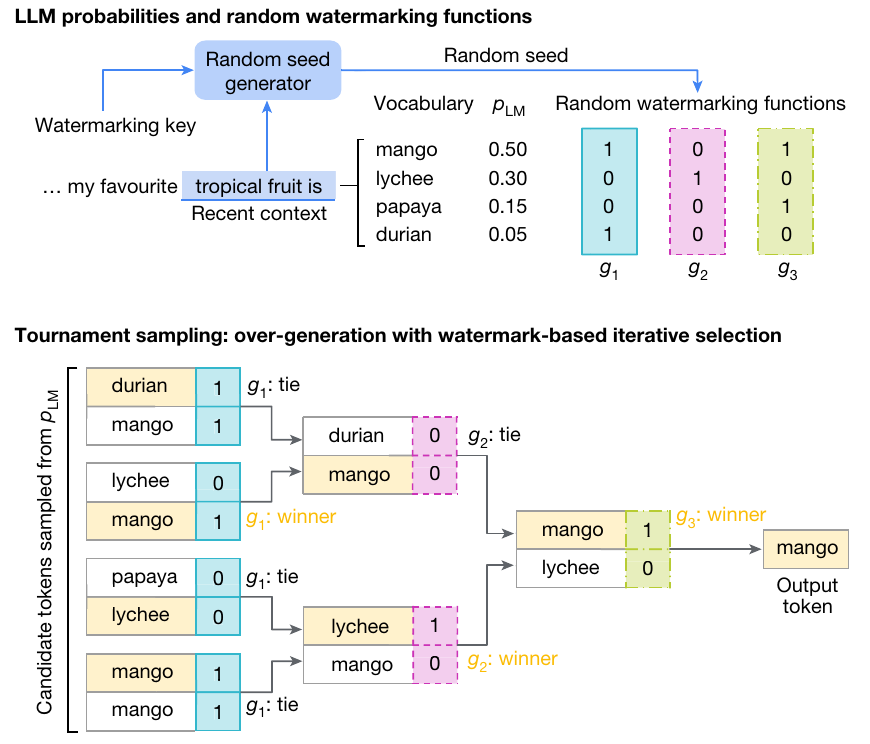
그림 2. SynthID-Text 논문의 Fig. 2. 위는 문맥·키로 만드는 점수, 아래는 후보 토큰의 토너먼트다.
그림에는 mango, lychee, papaya, durian이 등장한다. 확률이 높은 토큰은 처음 후보를 뽑을 때 더 자주 나온다. 이후 각 대결에서는 해당 층의 점수가 승자를 정한다.
후보를 여러 개 만든다고 모델에게 문장을 여러 번 끝까지 작성하게 시키는 것은 아니다. 다음 토큰의 샘플링 단계에서 일어나는 과정이다.
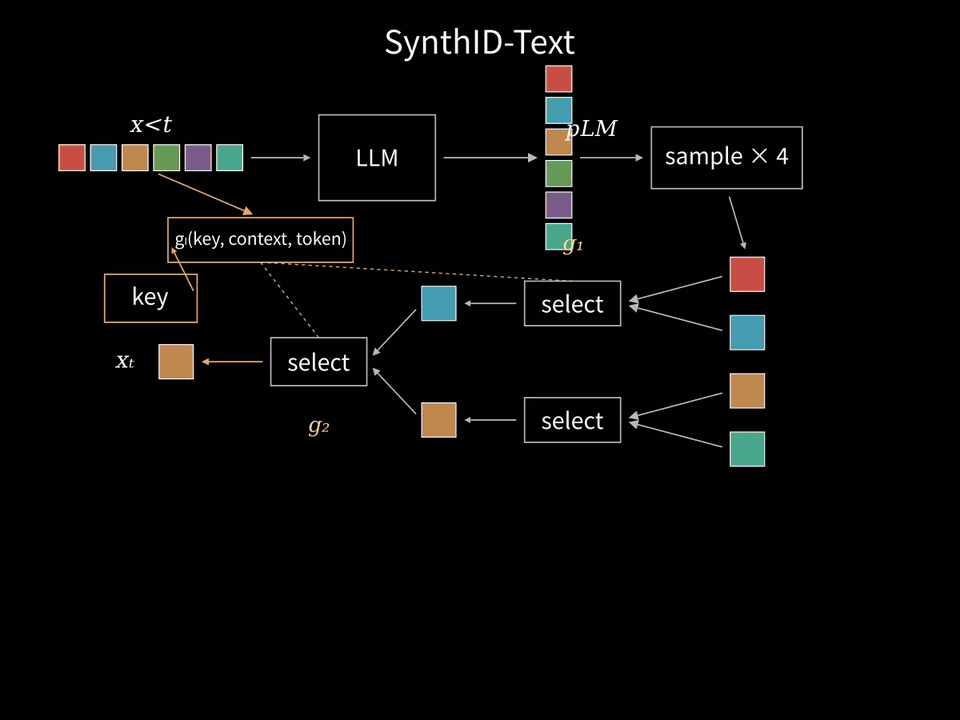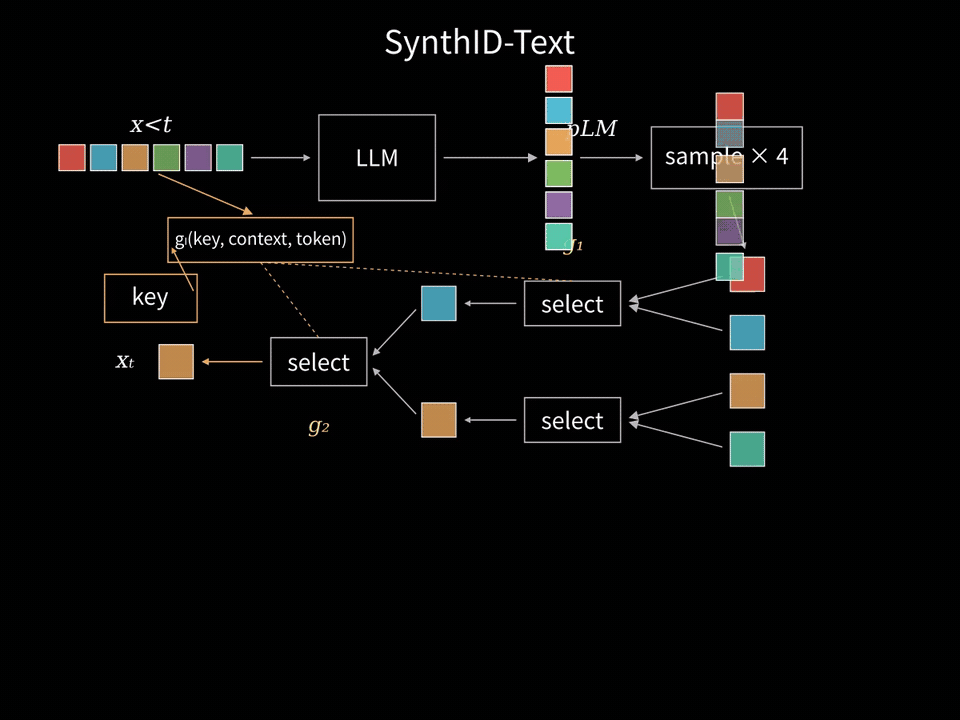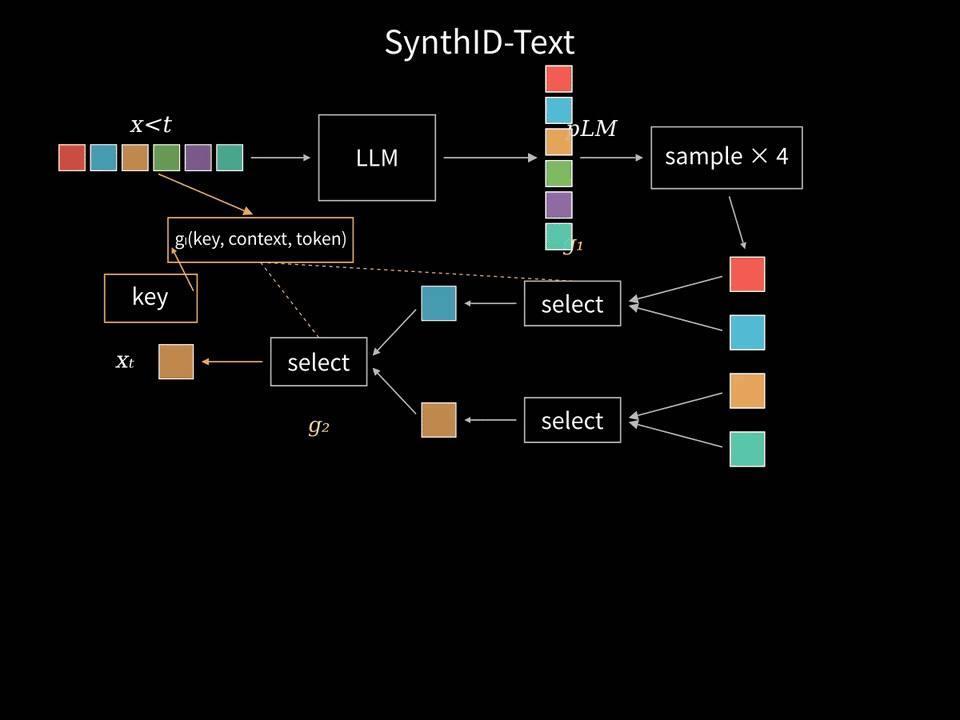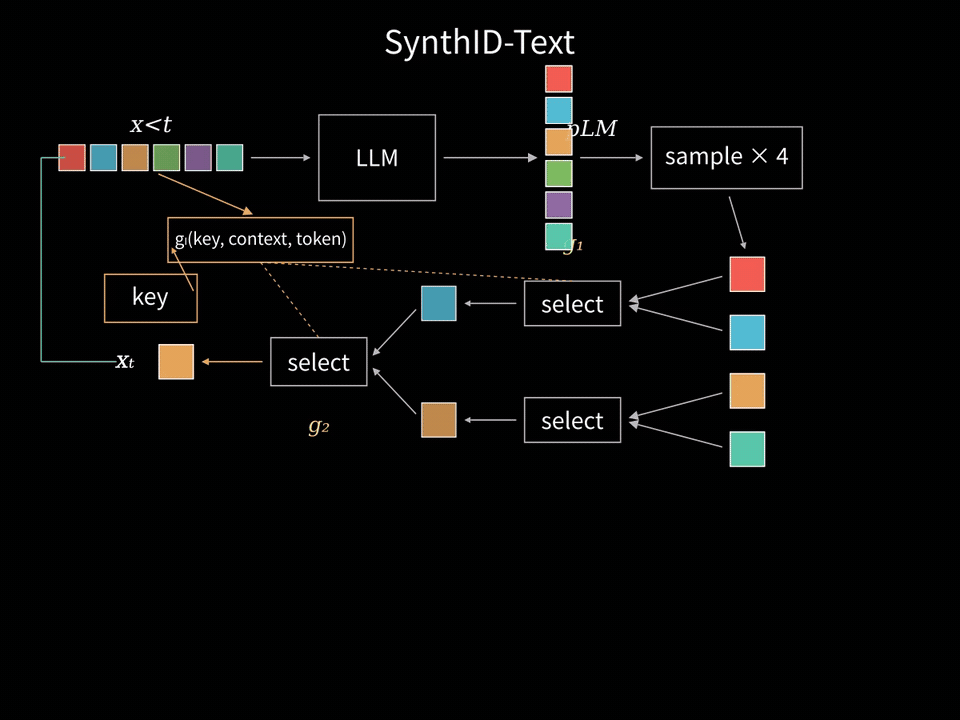
모델 분포에서 후보 토큰을 뽑고, 문맥·키·토큰으로 만든 gₗ 점수를 이용해 후보를 쌍별로 선택한다.
위의 figure에서 4개 후보가 두 층의 선택을 거쳐 하나로 줄어드는 구조를 시각화해서 확인할 수 있다.
같은 문맥·층에서 같은 토큰은 같은 점수를 받으며, 점수가 같으면 무작위로 선택한다.
키 점수를 보고 고르면서 원래 분포를 유지할 수 있을까?
내가 가장 궁금했던 부분이다. 원래 분포가 A: 0.8, B: 0.2이고, 두 후보를 독립적으로 뽑는다고 하자.
같은 토큰끼리 붙으면 그 토큰이 남고, 서로 다르면 키의 점수가 승자를 정한다.
후보 쌍 | 확률 | 승자 |
|---|---|---|
A, A | 0.8² = 0.64 | A |
A, B 또는 B, A | 2 × 0.8 × 0.2 = 0.32 | 키 점수에 따라 달라짐 |
B, B | 0.2² = 0.04 | B |
키 점수의 분포가 A와 B를 대칭적으로 취급한다면, 서로 다른 후보가 붙었을 때 A가 이길 확률은 키에 대해 평균내어 1/2이다.
따라서 A의 최종 확률은 0.64 + 0.32 × 0.5 = 0.80이다. B도 0.20으로 돌아온다. 키 점수에 영향을 받는데도 평균적인 토큰 분포는 유지되는 것이다.
그런데 같은 문맥에서 키 점수를 고정해 A가 항상 이긴다면 A의 확률은 0.64 + 0.32 = 0.96이다. B가 항상 이기면 A의 확률은 0.64다. 둘을 평균내면 다시 0.80이 된다.
이 계산은 특정 문맥·키에서의 조건부 분포와 키에 대해 평균낸 분포가 다를 수 있다는 것을 보여준다.
Er[q(v∣x<t,r)]=pLM(v∣x<t)
논문이 구분하는 한 토큰·한 문장·여러 응답의 분포 보존은 보장 범위가 서로 다르다.
반복 문맥 처리도 영향을 준다. 평균 분포가 같다는 한 문장만 읽고, 고정된 키를 쓰는 실제 서비스의 모든 출력이 동일하거나 응답 다양성이 그대로라고 받아들이면 안 된다.
반대로 위 예제에서 조건부 분포가 달라진다는 이유만으로 모든 워터마크가 평균 품질을 반드시 떨어뜨린다고 결론낼 수도 없다.
검출은 점수가 우연보다 높은지 보는 일
검출기는 결과 글의 문맥과 키로 점수 함수를 다시 만들고, 관측된 토큰들의 점수를 모은다.
생성 때 점수가 높은 후보가 더 자주 살아남았다면, 충분히 긴 글에서는 우연으로 기대되는 점수와 차이가 생긴다.
Score(x)=1mN∑t=1N∑ℓ=1mgℓ(xt,rt)
이 식은 논문에 제시된 평균 점수다. m은 점수 함수의 층 수, N은 점수를 계산한 토큰 수다. 실제 검출에는 반복 문맥 처리와 임계값 보정이 필요하다.
점수가 높다는 것은 선택한 기준 아래에서 그 키의 워터마크와 일치하는 증거가 강하다는 뜻이지, 작성자의 신원이나 글의 정확성을 증명하는 것은 아니다.
OpenAI의 textGrain: 키와 토큰의 의존성을 조절한다
OpenAI는 2026년 10월 5일 textGrain 보고서를 공개했다.
API는 당시 기본적으로 워터마크가 꺼져 있고, 지원 모델에 대해 고객이 선택해서 켤 수 있다고 발표했다.
이 현재 정책만으로 여름에 동료가 사용한 GPT Sol의 당시 설정까지 알 수는 없다.
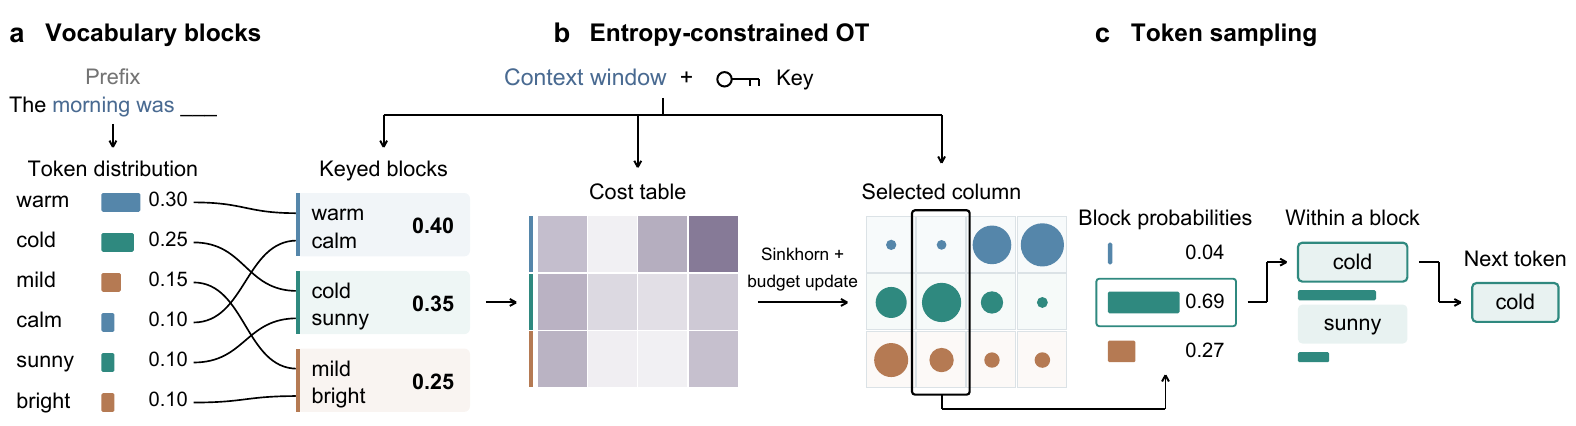
그림 3. textGrain 보고서의 Fig. 1. 토큰을 키 기반 블록으로 묶고, 엔트로피 예산 아래에서 블록의 조건부 분포를 구성한 뒤 토큰을 뽑는다. 출처: OpenAI 기술보고서, 2026.
어휘 블록을 만들되, Green 보너스를 주지는 않는다
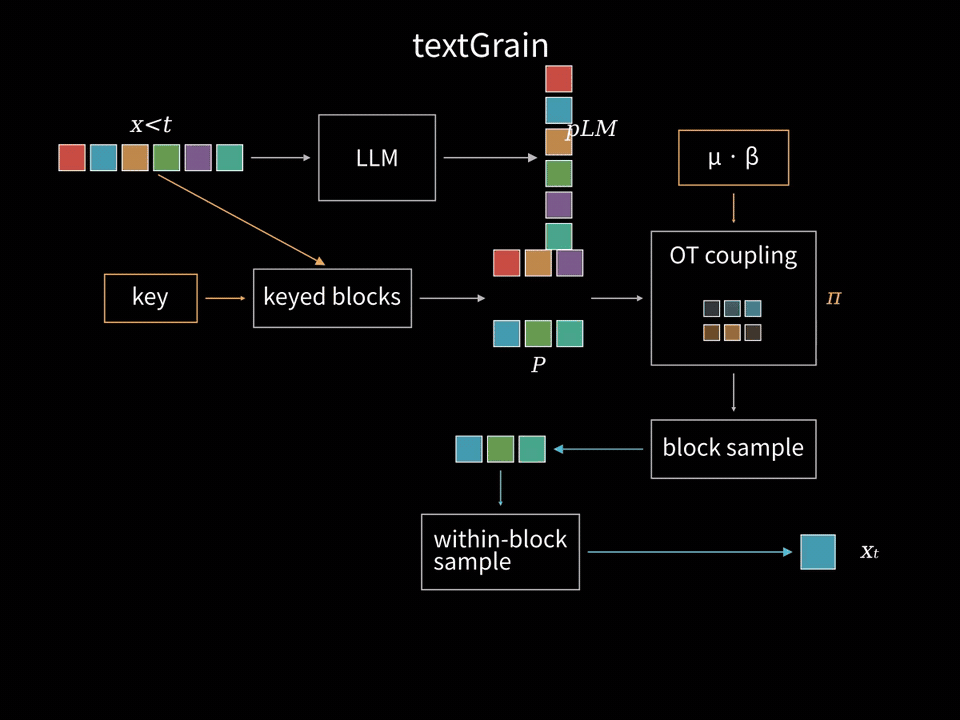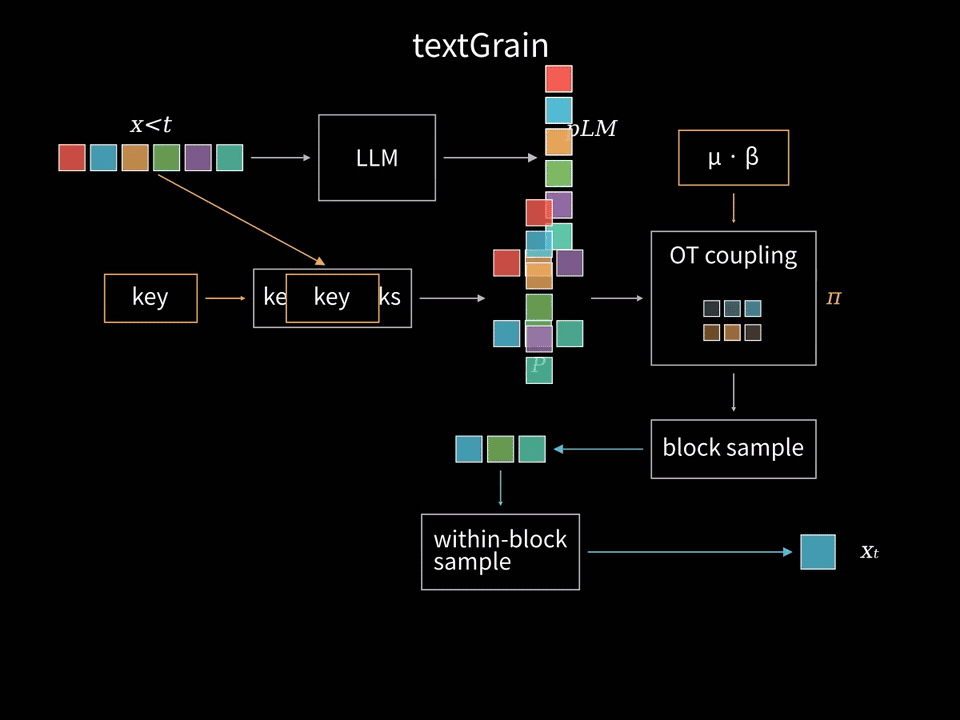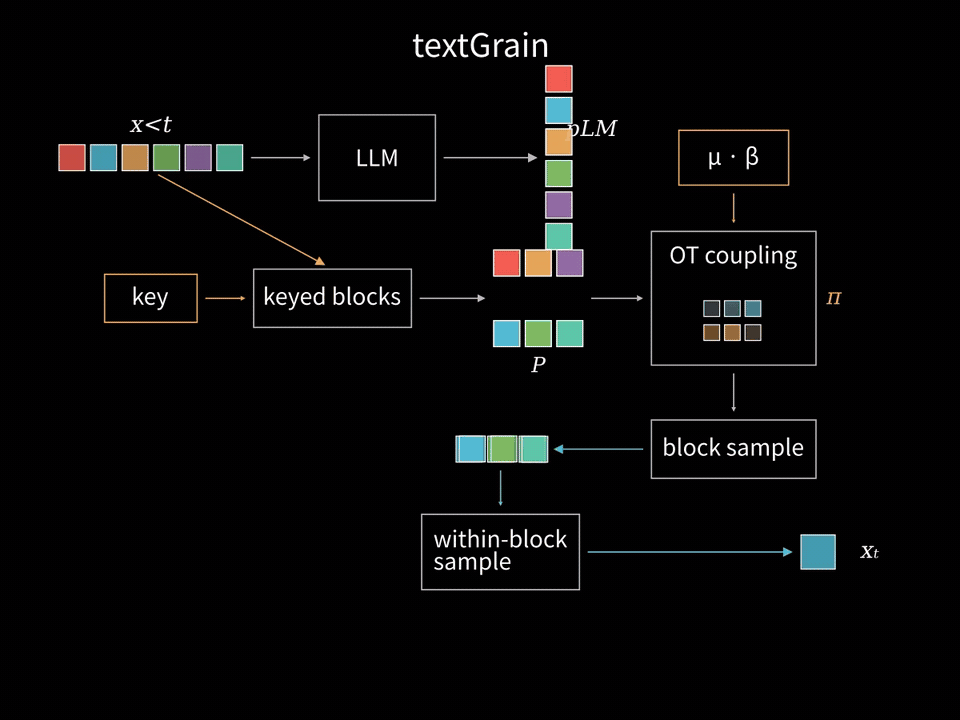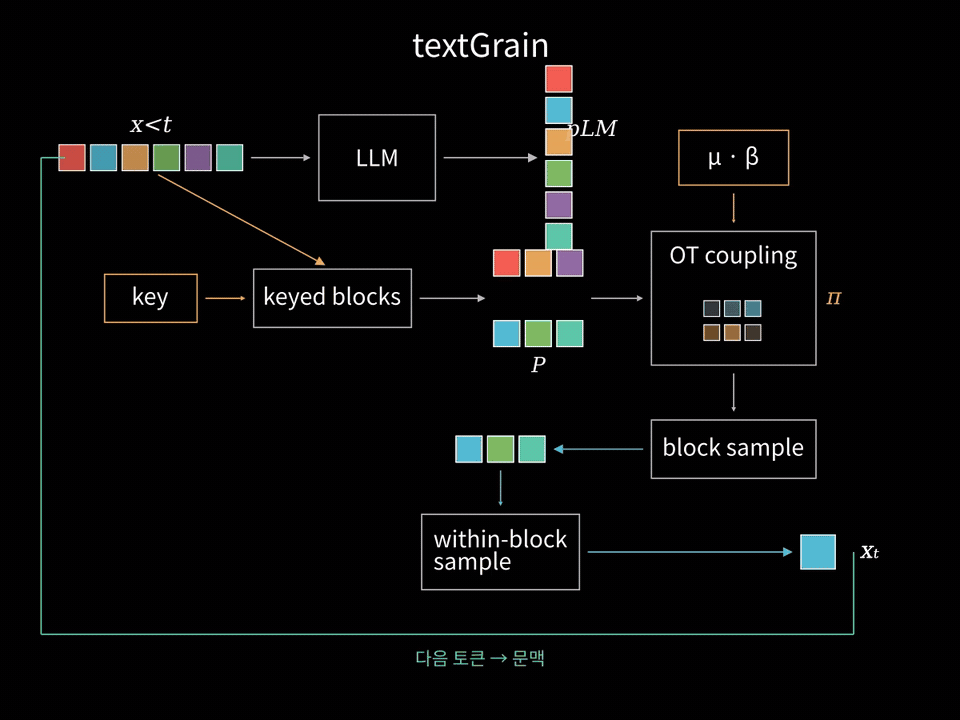
문맥·키에 따라 어휘를 블록으로 묶고, 모델의 확률을 블록 단위로 합친다.
OT coupling은 엔트로피 제어 파라미터 μ·β를 반영해 결합분포 π를 만든다.
키 기반 선택을 반영한 블록 샘플링 뒤에는 고른 블록 안에서 모델의 원래 확률 비율로 토큰을 샘플링한다.
출력 토큰은 다음 문맥으로 돌아간다.
textGrain도 키와 문맥을 이용해 어휘를 나누지만, 여러 블록에 토큰을 배정한다.
각 블록의 원래 확률은 그 안에 있는 토큰 확률의 합이다.
블록을 선택한 다음에는 블록 내부의 원래 상대 확률로 토큰을 뽑는다.
블록 선택을 정하는 것은 optimal transport, 즉 최적수송으로 구성한 결합분포다.
블록과 키 기반 난수의 조합에 Gumbel 값으로 비용을 정하고, 선호되는 조합이 더 자주 선택되게 한다.
동시에 주변분포 제약을 두어 난수에 대해 평균내면 원래 블록 확률로 돌아오게 한다. 독립분포에서 벗어나는 정도에는 KL 페널티를 붙여 의존성을 제한한다.
어휘 전체 대신 블록에서 계산하면 최적화 차원도 줄일 수 있다.
예를 들어 확률이 0.60인 토큰 A와 0.10인 C가 같은 블록이라면, 그 블록을 고른 뒤에는 A:C = 6:1로 샘플링한다.
블록 선택은 키에 의존하지만 내부 비율은 유지한다.
키 기반 난수에 대해 평균낸 블록 선택 확률까지 원래 0.70으로 맞추면, A와 C의 전체 평균 확률도 각각 0.60과 0.10으로 돌아온다.
워터마크 강도를 엔트로피 예산으로 정한다
분포를 평균적으로 보존해도 고정된 키 아래에서 선택이 거의 결정적일 수 있다.
textGrain은 그래서 평균적인 조건부 샘플링 엔트로피 손실에 예산을 둔다.
아래 식의 KL 발산은 키 기반 난수와 토큰의 상호정보량이며, 키를 알게 됐을 때 줄어든 샘플링 불확실성과 같다.
DKL(π‖P⊗μ)=I(W;Ξ)=H(W)−H(W∣Ξ)I(W;Ξ)≤βH(W)
W는 선택한 토큰, Ξ는 키 기반 난수, π는 둘의 결합분포다. 이 식은 두 변수의 의존성이 커질수록 키를 안 상태에서 남는 샘플링 엔트로피가 줄어든다는 뜻이다.
H는 엔트로피로, H(W) = −Σᵥ p(v) log p(v)다. β는 허용 손실의 비율이다. 예를 들어 H(W)가 2이고 β가 0.1이면 평균 손실을 0.2 이하로 제한하는 식이다.
여기서 ‘엔트로피 손실 10%’를 ‘문장 품질 10% 하락’으로 해석하면 안 된다. 측정하는 것은 선택의 불확실성이며 문장의 자연스러움 점수가 아니다.
원래 확률분포에서 매우 좁게 샘플링하는 모델도 좋은 문장을 만들 수 있고, 반대로 다양하게 생성한다고 PRD에 적합한 표현이 보장되지도 않는다.
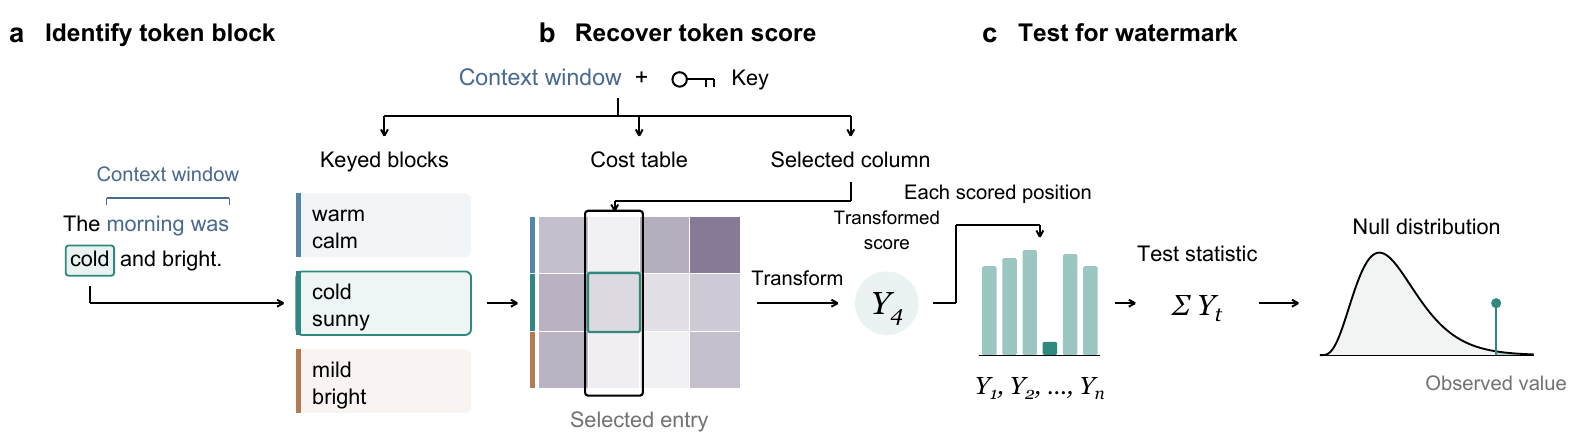
그림 4. textGrain 보고서의 Fig. 2. 관측한 토큰의 블록과 키 기반 점수를 복원해 검정 통계량을 만든다.
출처: OpenAI 기술보고서, 2026.
검출기는 생성 때의 확률분포를 몰라도 된다
검출기는 출력 토큰과 앞선 문맥, 키를 이용해 각 토큰의 블록과 Gumbel 기반 점수를 재구성한다.
생성 과정에서 키와 연결된 조합을 더 자주 선택했다면, 관측 점수를 누적했을 때 기준 분포와 차이가 생긴다.
보고서는 이를 통계적 증거로 바꾸는 검출 절차와 보장 조건을 설명한다. 같은 키·토크나이저·설정은 필요하지만 생성 모델의 다음 토큰 확률이나 생성 시 엔트로피 예산은 필요하지 않다.
KGW는 Green 횟수, SynthID-Text는 토너먼트 점수, textGrain은 블록과 난수의 관계를 관측한다.
서로 다른 통계량을 사용해도, 생성 때 남긴 패턴이 우연으로 얼마나 설명되는지 묻는다는 점은 이어진다.
짧은 글은 표본이 작고, 편집으로 토큰과 문맥이 바뀌면 신호가 약해질 수 있다. 결정론적이 아니기 때문이다!
KGW를 기준으로 두 논문의 차이 비교하기
비교 항목 | KGW · soft 방식 | SynthID-Text · 비왜곡 설정 | textGrain |
|---|---|---|---|
생성 | Green 토큰 logit에 δ 추가 | 원래 분포에서 뽑은 후보의 점수 토너먼트 | 블록과 키 기반 난수의 최적수송 결합 후 토큰 샘플링 |
검출 | Green 토큰의 초과 출현 | 출력 토큰의 누적 워터마크 점수 | 관측 블록과 재구성한 난수 점수의 통계적 관계 |
분포 | 보너스로 원래 분포 변경 | 설정과 조건에 따라 난수에 대해 평균낸 분포 보존 | 주변분포 제약으로 난수에 대해 평균낸 다음 토큰 분포 보존 |
핵심 조절 대상 | Green 비율 γ, 보너스 δ | 토너먼트 층 수와 점수·반복 문맥 설정 | 블록 결합과 평균 엔트로피 손실 예산 |
내가 읽은 연결점은 KGW가 보여준 ‘샘플링에 패턴을 남기면 나중에 통계적으로 검출할 수 있다’는 원리다.
SynthID-Text는 이를 후보 토너먼트로 구현하고 분포 보존과 대규모 운영을 살핀다. textGrain은 결합분포를 직접 설계하며 고정된 키에서 남는 샘플링 자유도까지 수치로 조절한다.
이 비교는 설명을 위한 순서이며, KGW에서 두 방식으로 단일하게 발전했다는 계보를 주장하는 것은 아니다.
SynthID-Text의 Evaluation, textGrain의 Sections 2–3 및 Appendix C
논문의 품질 실험은 무엇을 보여줄까?
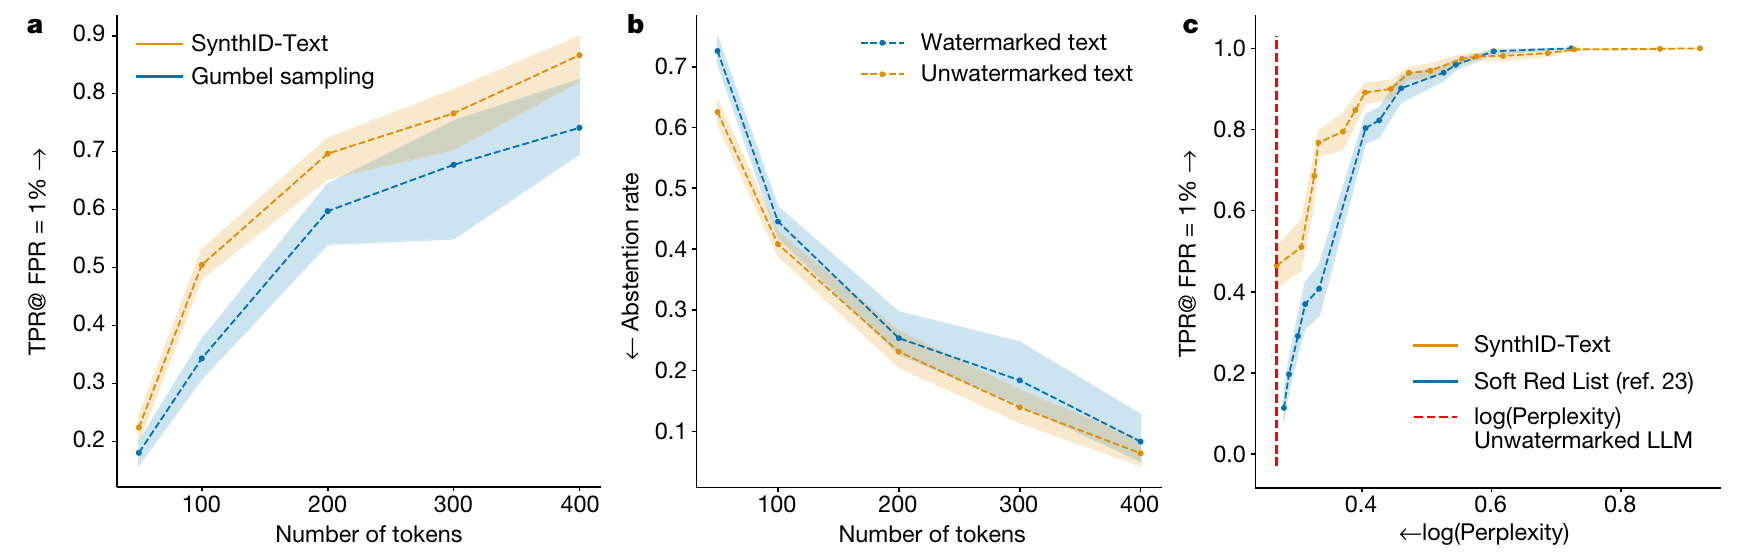
그림 5. SynthID-Text 논문의 Fig. 3. 왼쪽은 길이에 따른 검출률, 가운데는 선택적 검출의 보류 비율, 오른쪽은 분포를 바꾸는 설정의 검출률·log perplexity 관계다.
왼쪽 그래프의 세로축은 TPR@FPR=1%다. 워터마크가 없는 글을 잘못 양성으로 판정하는 비율을 1%로 맞췄을 때, 워터마크가 있는 글을 얼마나 찾아내는지 보여준다.
‘검출기의 전체 정확도가 99%’라는 뜻이 아니다. 텍스트가 길수록 모을 수 있는 증거가 늘어난다. 가운데의 abstention도 오검출률과 다른 값으로, 판단을 보류하는 비율이다.
오른쪽 그래프는 distortionary 설정을 비교한다. 워터마크의 존재 자체와 강한 검출 신호를 위해 분포를 바꾸는 설정을 구분해서 읽어야 한다.
perplexity는 생성 글이 모델 아래에서 얼마나 그럴듯한지 보는 대리 지표다. PRD의 요구사항이 정확한지, 팀에서 자연스럽게 읽히는지는 별도로 평가해야 한다.
SynthID-Text 논문은 비왜곡 설정에서 사람의 품질 비교와 약 2천만 건의 Gemini 응답 피드백 등을 살폈고, 유의한 품질 차이를 관찰하지 않았다고 보고한다.
이 결과는 해당 모델·설정·평가에서의 근거다.
Anthropic도 자체 평가에서 내용·창의성·가독성에 영향을 관찰하지 않았다고 설명한다.
OpenAI 역시 Astra 벤치마크와 제품 지표에서 의미 있는 품질 차이를 보지 못했다고 발표했다.
회사가 제시한 평균 평가 결과와 특정 팀의 체감 품질은 측정하는 범위가 다르다.
임커밋 영상의 6:09 이후에서는 품질과 무관한 기준이 선택에 개입할 때 생길 수 있는 성능 문제를 설명한다. 그 문제의식은 내가 들은 PRD 사례와 연결된다.
다만 일반적인 LLM 샘플링도 항상 1위 후보를 고르는 것은 아니므로, 그 설명을 ‘워터마크는 반드시 최선의 단어를 버리고 평균 품질을 떨어뜨린다’는 증명으로 읽지는 않았다.
다시 PRD Generator Agent의 페인포인트로
처음에는 어떻게 표시를 숨기는지가 궁금했는데, 논문을 읽고 나니 모델 선택 이후에 어떤 평가를 붙여야 하는지가 더 구체적으로 보였다.
PM이 불편해한 것은 워터마크의 검출 가능성보다 실제로 읽고 쓸 문장의 품질이었다.
예를 들어 ‘사용자는 결제 전에 총액을 확인할 수 있어야 한다’에서 ‘있어야 한다’를 ‘있을 수 있다’로 바꾸면, 문법적으로는 문장이지만 필수 요구사항의 강도가 달라진다.
‘저장한다’와 ‘보관한다’도 문맥에 따라 책임과 기간이 다르게 읽힐 수 있다.
그래서 이 Agent를 평가한다면 다음처럼 나눠서 보겠다.
볼 항목 | PRD에서 확인할 내용 |
|---|---|
단어의 자연스러움 | PM이 수정한 어색한 표현을 문장 단위로 기록하고, 문서 길이를 고려해 비교 |
요구사항 의미 | 필수·권장·선택의 강도, 주체, 조건, 수치가 원래 입력과 일치하는지 확인 |
용어 일관성 | 동일한 기능·화면·상태를 문서 전체에서 같은 이름으로 부르는지 확인 |
실제 수정 부담 | 완성까지의 수정 시간과 모델을 모르는 상태에서의 PM 선호도를 비교 |
응답 다양성 | 같은 요청을 반복했을 때 문구만 반복하는지, 다른 유효한 접근도 나오는지 확인 |
이번에 배운 것은 텍스트 워터마크가 샘플링의 자유도를 이용해 남기는 통계적 신호라는 점이다.
그 신호를 강하게 남기는 일, 원래 분포를 보존하는 일, 같은 프롬프트에서 다양한 응답을 얻는 일은 함께 따져야 한다.
PRD Generator Agent에서는 여기에 요구사항의 의미와 PM의 수정 부담까지 붙는다.
‘품질에 영향이 없다’는 설명을 읽을 때도, 그 품질이 내가 만들고 있는 제품에서 무엇을 뜻하는지부터 확인해야겠다.
참고 자료
Kirchenbauer et al. — A Watermark for Large Language Models, 2023
OpenAI — Our approach to EU text provenance rules, 2026.10.05
본문의 데이터 흐름 애니메이션 3개는 3Blue1Brown의 오픈소스 Manim에서 출발한 Manim Community로 만들었다.
rydnsj200 님의 최신 블로그
더보기
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.